

llama.cpp MTP-Support : Modèles locaux 27B 1,7 fois plus rapides sur les GPU grand public
Le PR 22673 intègre la prédiction multi-tokens dans la version principale de llama.cpp.
7 min de lecture
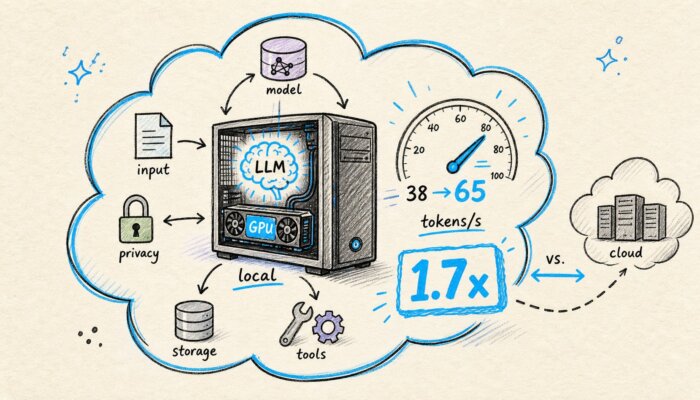
Le 16 mai 2026, la PR #22673 a été mergée dans llama.cpp. Le Multi-Token Prediction tourne depuis dans la mainline. Sur une RTX 3090, Qwen3.6 27B passe ainsi de 38 à 65 tokens par seconde, soit environ 1,7x plus rapide. Ce n’est pas une actualité d’hyperscaler, mais cela déplace un calcul que beaucoup d’équipes DACH gardent en tête depuis un an et demi : à partir de quand l’inférence locale vaut-elle la peine, et à partir de quand pas.
L’essentiel en bref
- MTP n’est pas une astuce valable pour tout l’univers des modèles. L’accélération ne fonctionne que sur des modèles entraînés avec des têtes MTP, actuellement Qwen3.5, Qwen3.6, DeepSeek V3, DeepSeek R1 et Gemma 4.
- Le chiffre de 1,7x est réel, mais lié au matériel. Il provient du setup RunPod RTX 3090 avec Qwen3.6 27B. Sur d’autres cartes et avec d’autres quantifications, la valeur se situe entre 1,4x et 2x.
- Dans le débat sur les coûts des tokens, la frontière se déplace. L’inférence locale avec un GPU grand public dans le parc interne devient moins chère, sans que la classe H100 ne devienne soudain obsolète. Où la bascule vaut-elle la peine, où pas.
À lire aussi :EKS 1.36 devient cher sans FinOps / Patcher le RCE de la Gemini CLI dans le CI/CD
Ce que fait MTP techniquement et pourquoi il doit être intégré dans le modèle
Le Multi-Token Prediction est, en substance, une forme de Speculative Decoding dans laquelle un second réseau de prédiction ne tourne pas à côté de manière externe, mais siège directement dans le modèle principal comme tête de sortie supplémentaire. La tête MTP propose plusieurs tokens à la fois, le modèle principal les vérifie lors du forward pass suivant et les accepte ou les rejette. Quand le taux de réussite est au rendez-vous, le nombre de forward passes coûteux par mot généré baisse de manière mesurable.
La différence décisive avec le speculative decoding classique à base d’un modèle draft séparé est de nature très pratique. Pas besoin d’un second modèle qu’il faut charger en parallèle et maintenir en VRAM. Sur des modèles 27B sur une carte de 24 Go, cela libère précisément la marge que le draft consommait auparavant. En pratique, cela signifie qu’une RTX 3090 ou 4090 obtient avec MTP un gain de vitesse qu’elle n’aurait jamais pu obtenir proprement avec un modèle draft séparé, ne serait-ce que pour des raisons de VRAM.
Le flag dans llama.cpp s’appelle depuis le merge –spec-type draft-mtp. Le patch vient de am17an, et la conversation autour de la PR #22673 montre clairement que le code est bien fonctionnel, mais que la tête MTP doit être présente dans le checkpoint du modèle. Sans tête MTP, le flag ne fait tout simplement rien.
Ce que signifie concrètement le chiffre de 1,7x
La barre des 1,7x, souvent citée, provient d’un benchmark RunPod avec Qwen3.6 27B sur une RTX 3090. Sans MTP, le setup délivre 38 tokens par seconde en single stream. Avec la tête MTP activée, on atteint 65. Cela fait une différence de 27 tokens par seconde. C’est ce qui sépare une interaction agréable en local d’une interaction qui peine comme une vieille machine à écrire.
Qui veut extrapoler ces chiffres vers d’autres matériels doit rester prudent. Sur une 4090, la courbe se déplace, car le forward pass y est de toute façon plus rapide et la part économisée par MTP paraît relativement plus faible. Les premiers retours de la communauté évoquent plutôt 1,4x à 1,6x. Pour Gemma 4 26B, les retours font état d’environ 40 pour cent de gain de vitesse. Une fourchette réaliste pour les prochaines semaines : de 1,4x à presque 2x, selon le modèle, la carte et le niveau de quantification.
Quels modèles embarquent MTP aujourd’hui et lesquels non
MTP n’est pas un interrupteur que l’on peut activer sur n’importe quel GGUF. La tête doit avoir été créée lors du pretraining ou du fine-tuning, sinon il n’existe tout simplement aucune prédiction que le modèle principal pourrait consommer. À ce jour, cela se limite à une liste de modèles très restreinte.
MTP disponible nativement
- Qwen3.5 à partir de 7B et plus
- Qwen3.6 27B et variantes A3B-MoE
- DeepSeek V3 et R1
- Gemma 4 26B dans sa variante A4B
Sans tête MTP, aucun gain de vitesse
- Llama 3 dans toutes les tailles
- les familles Mistral et Mixtral
- les versions de Gemma antérieures à Gemma 4
- les fine-tunes maison sans tête explicitement entraînée
Qui a construit ces derniers mois sur un setup Llama 3 70B ne gagne pour l’instant rien au merge. La question n’est pas de savoir si l’on active MTP, mais si l’on est prêt à changer de modèle de base. Pour la génération de code et le tool calling, beaucoup plaident actuellement pour regarder de près Qwen3.6. Pour les pipelines RAG classiques qui tournent de manière stable avec Llama 3 depuis un an, un changement serait une pure économie de principe, qui introduit d’autres risques, du comportement des prompts aux différences de tokenizer.
La réalité du matériel entre 3090, 4090, 5090 et H100
La question passionnante n’est pas de savoir si MTP a encore un effet sur une H100. La réponse y est prévisible et moins spectaculaire. La vraie question est de savoir où se situe le seuil à partir duquel un GPU grand public plus MTP peut sérieusement passer pour un substitut d’inférence à une heure d’API.
Sur une RTX 3090 avec 24 Go de VRAM, Qwen3.6 27B en quantification Q4 avec MTP atteint environ 65 tokens par seconde, avec des longueurs de contexte stables jusqu’à 8k. Cela suffit pour une assistance au code au niveau de l’équipe, pour des réponses RAG de longueur moyenne, pour l’extraction structurée. Là où cela ne suffit pas : un fonctionnement multi-utilisateurs simultané avec une forte concurrence. Dès que trois collaborateurs interrogent en parallèle, le gain perçu retombe.
La 4090 ne résout cela qu’en partie. Plus de bande passante, plus de puissance de calcul, mais toujours la classe 24 Go. Qui veut sérieusement servir plusieurs flux en parallèle se retrouve sur la 5090 avec 32 Go ou directement sur H100/H200. Et c’est exactement là que se trouve ce que beaucoup d’équipes sous-estiment : MTP est une réponse pour le cas à flux unique, pas pour un fonctionnement multi-clients à forte charge. En datacenter, la H100 reste la solution plus honnête. Sur la workstation d’ingénieur ou dans le petit cluster interne, la 4090 avec MTP devient soudainement plus intéressante qu’elle ne l’était il y a trois semaines.
Quand l’inférence locale devient réellement rentable face aux hyperscalers
Le calcul évident paraît d’abord simple. Une 4090 coûte environ 1 700 euros en achat interne. Ajoutez l’électricité, la maintenance et l’amortissement sur trois ans. Si le setup traite plusieurs millions de tokens par jour, c’est moins cher que chaque heure d’API chez OpenAI, Anthropic ou AWS Bedrock. C’est ce que dit la slide. Elle n’est pas si honnête que cela.
Ce que les slides montrent rarement, c’est la réalité opérationnelle. L’inférence locale, ce n’est jamais seulement la carte. C’est aussi l’équipe qui met à jour le modèle. C’est la responsabilité des mises à jour de quantification, la question de savoir si Q4_K_M ou Q8_0 est le bon niveau pour le besoin du prochain trimestre. C’est la pipeline de logs qui doit devenir exploitable pour le monitoring. C’est la disposition de quelqu’un à maintenir le stack d’inférence au lieu de simplement l’utiliser.
J’ai déjà pris l’inférence locale au sérieux une fois, trop tôt. C’était en 2024, avec un modèle 13B sur une 3090. Le comparatif de coûts sur le papier avait l’air bon, en réalité trois heures d’ingénierie par semaine de maintenance ont englouti l’avantage de coût. Aujourd’hui, avec MTP et avec des modèles qui font leur travail de manière plus fiable en 27B, le calcul change. Mais il ne change pas tout seul.
La fourchette honnête est, à mon sens, la suivante. L’inférence locale avec un modèle 27B compatible MTP vaut la peine si l’équipe peut investir au moins l’équivalent d’une journée par mois en temps d’ingénierie pour le stack, si les workloads se concentrent sur quelques flux par heure et si les réponses n’ont pas besoin de rivaliser à chaque seconde avec l’absolu sommet. Elle ne vaut pas la peine si l’on attend la qualité de réponse de GPT-5 ou de Claude 4, si une concurrence multi-tenant est nécessaire et si l’équipe n’est pas prête à considérer les GGUF comme une tâche continue.
Questions fréquentes
Qu’est-ce que le Multi-Token Prediction dans llama.cpp, concrètement ?
MTP est une forme de Speculative Decoding dans laquelle une tête de sortie supplémentaire intégrée directement dans le modèle principal propose plusieurs tokens à la fois. Le modèle principal les vérifie lors du forward pass suivant et les accepte ou les rejette. Contrairement au Speculative Decoding classique, aucun second modèle draft n’est chargé en parallèle.
Quels modèles puis-je accélérer aujourd’hui avec MTP ?
Les modèles qui ont reçu une tête MTP lors du pretraining. Concrètement, il s’agit actuellement de Qwen3.5 à partir de 7B, de Qwen3.6 y compris 27B et A3B-MoE, de DeepSeek V3, de DeepSeek R1 et de Gemma 4 26B-A4B. Llama 3, Mistral et les versions de Gemma antérieures n’ont pas de tête MTP et n’en profitent pas.
Quel est réellement le gain de vitesse ?
Le chiffre de 1,7x souvent cité provient d’un benchmark Qwen3.6 27B sur RTX 3090, avec 38 contre 65 tokens par seconde. Sur d’autres cartes et avec d’autres modèles, la fourchette se situe selon les retours de la communauté entre 1,4x et 2x. Gemma 4 26B se situe plutôt à 1,4x.
Quel flag dans llama.cpp active MTP ?
Depuis le merge de la PR #22673 le 16 mai 2026, le flag s’appelle –spec-type draft-mtp. Condition préalable : le modèle chargé doit réellement posséder une tête MTP dans son checkpoint. Sans tête, le flag ne fait rien.
MTP suffit-il pour remplacer les API des hyperscalers ?
Pour des workloads à flux unique sur une workstation d’ingénieur ou un petit cluster interne, MTP déplace nettement le calcul des coûts. Pour la haute charge multi-tenant ou pour une qualité de sommet absolu, les modèles d’API restent pour l’instant le choix le plus honnête. La réalité opérationnelle, c’est-à-dire la maintenance des GGUF, le tuning de la quantification et le monitoring, continue de coûter du temps d’ingénierie.
Plus du réseau MBF Media
MyBusinessFutureL’AI Act a déjà commencé, et pas seulement en aoûtDigital ChiefsQui pilote réellement la facture cloudSecurityTodayZero-Day Exchange CVE-2026-42897 : le spoofing OWA force les CISO DACH à patcher immédiatementSource de l’image : générée par IA (juin 2026), certificat C2PA intégré dans l’image
Traduit de l’original allemand par intelligence artificielle. La version allemande fait foi.


