KIT-Forscher: So trainieren Kliniken KI ohne Datentausch
Ein KIT-Forscher erklärt, was Krankenhäuser beim föderierten Lernen austauschen, wie sicher der Ansatz ist und was bis zur klinischen Praxis fehlt.
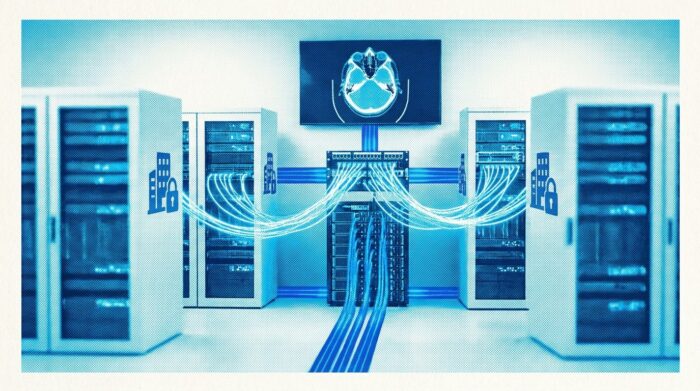
Die Patientendaten bleiben in jeder Klinik. Gemeinsam entsteht trotzdem ein KI-Modell, das synthetische CT-Bilder für die Strahlentherapie erzeugt. Ciro Benito Raggio vom KIT erklärt, wo dabei die Sicherheitsrisiken liegen und warum das Verfahren seiner Forschungsgruppe je nach Architektur 9 bis 23 Prozent Rechenaufwand spart.
Das Wichtigste in Kürze
- Zwischen den Kliniken wandern nur Modell-Updates. Ein zentraler Server bündelt sie zu einem neuen gemeinsamen Modell.
- Dezentrale Daten garantieren für sich genommen keine Privatsphäre. Die Forschungsgruppe hat Rekonstruktions- und Inferenzangriffe samt Gegenmaßnahmen geprüft.
- Adaptiv eingefrorene Netzwerkschichten senken Rechenaufwand und CO₂-Emissionen um bis zu 23 Prozent. Vor dem klinischen Einsatz stehen dosimetrische, klinische und regulatorische Prüfungen aus.
Verwandt:Confidential Computing wird Betriebs-Standard / Midjourneys Körperscanner ist ein Compute-Problem
Was ist föderiertes Lernen? Beim föderierten Lernen trainieren mehrere Einrichtungen ein gemeinsames KI-Modell, ohne ihre Daten zusammenzuführen. Jede Einrichtung trainiert vor Ort mit den eigenen Daten. Ausgetauscht werden nur Informationen über die Anpassungen des Modells.
Für die Planung einer Strahlentherapie brauchen Kliniken mehrere bildgebende Verfahren. CT-Aufnahmen sind unter anderem für die Berechnung der Strahlendosis nötig. MRT-Bilder stellen Organgewebe besonders kontrastreich dar, CBCT-Aufnahmen helfen, Patientinnen und Patienten während der Behandlung präzise zu positionieren. KI-Modelle können aus MRT- oder CBCT-Aufnahmen synthetische CT-Bilder erzeugen. Solche Bilder könnten laut KIT künftig in bestimmten Anwendungsfällen zusätzliche CT-Aufnahmen ersetzen und damit die Belastung durch weitere Röntgenstrahlung senken.
Die Forschungsgruppe Medizinische Bildgebung für Modellierung und Simulation von Professorin Maria Francesca Spadea am Institut für Biomedizinische Technik des Karlsruher Instituts für Technologie (KIT) hat dafür föderierte Lernverfahren entwickelt und getestet. Ciro Benito Raggio, Wissenschaftler der Gruppe, hat die Fragen schriftlich auf Englisch beantwortet. Seine Antworten erscheinen hier in deutscher Übersetzung.
Was die Kliniken statt Patientendaten austauschen
Beim föderierten Lernen bleiben die Patientendaten in den Kliniken. Was tauschen die beteiligten Häuser stattdessen aus? Wer koordiniert das gemeinsame Training?
Wie die Frage richtig andeutet, werden die Daten beim föderierten Lernen nicht in eine zentrale Datenbank übertragen. Jede Einrichtung trainiert das Modell stattdessen lokal mit ihren eigenen Daten. Diese Daten bleiben in ihrer eigenen Infrastruktur.
Dieser alternative Trainingsansatz ist besonders in der Medizin relevant. Dort kann es schwierig sein, dass sich die beteiligten Einrichtungen über das Teilen von Daten und die Eigentumsrechte daran einigen. Das macht den klassischen Ansatz unpraktikabel, die Daten zentral zusammenzuführen.
Statt Daten teilen die beteiligten Einrichtungen, die sogenannten Clients, die Aktualisierungen ihrer Modellparameter mit einer zentralen Instanz, dem Server. Diese Updates bestehen aus numerischen Informationen darüber, wie sich das lokale Modell beim Training mit den Daten der einzelnen Klinik verändert hat.
Der Server führt die Updates mit einer Aggregationsstrategie zusammen und verteilt das aktualisierte Modell zurück an die Kliniken. Dort beginnt von einem gemeinsamen Ausgangspunkt aus ein neuer Trainingszyklus, eine neue Runde. Das wiederholt sich so lange, bis ein gemeinsames Modell auf den Daten der verschiedenen beteiligten Einrichtungen eine angemessene Leistung erreicht. Das prüfen geeignete Validierungsverfahren.
Diese Architektur mit zentralem Server ist einer der einfachsten und am weitesten verbreiteten Ansätze. Es gibt aber auch dezentrale Peer-to-Peer-Varianten, die nicht unbedingt einen zentralen Koordinator brauchen.
Unterschiedliche Scanner, ein gemeinsames Modell
Kliniken arbeiten mit unterschiedlichen Geräten und Aufnahmeprotokollen. Wie stellen Sie sicher, dass das gemeinsame Modell an jedem Standort verlässliche synthetische CT-Bilder liefert?
Das ist eine der größten Herausforderungen des föderierten Lernens in unserem Forschungsfeld. Unterschiedliche Scanner, Protokolle und Aufnahmeverfahren beeinflussen die Eigenschaften der Bilder und damit auch, wie gut sich das Modell anpassen kann. Deshalb ist es wichtig, die quantitativen und qualitativen Ergebnisse auf den Validierungsdaten jeder beteiligten Einrichtung sorgfältig zu analysieren.
In unseren Studien haben wir verschiedene Aggregationsstrategien und Deep-Learning-Architekturen untersucht, die zuvor im zentralen Training eingesetzt wurden. Sie erzeugen synthetische Computertomografie-Bilder (CT) aus der Magnetresonanztomografie (MRT) oder aus der Kegelstrahl-Computertomografie (CBCT). Ziel war es zu prüfen, ob sich föderiertes Lernen für diese Aufgabe eignet.
In unseren Experimenten haben wir mehrere Metriken zur Bildähnlichkeit ausgewertet und die synthetischen CT-Bilder mit den echten Referenzaufnahmen verglichen. Zusätzlich haben wir die erzeugten Bilder visuell begutachtet, um die Qualität der Ergebnisse über alle beteiligten Einrichtungen hinweg zu bewerten.
In dem untersuchten Versuchsaufbau zeigten die Ergebnisse nach den verwendeten Metriken und visuellen Bewertungen eine gute Ähnlichkeit zwischen synthetischen und echten Bildern. Bildähnlichkeit allein belegt aber noch keine klinische Verlässlichkeit.
Unsere Studien haben sich vor allem auf die technischen Aspekte konzentriert. Ob föderiert erzeugte synthetische CT-Bilder in der Strahlentherapie verlässlich eingesetzt werden können, müssen weitere Studien klären. Sie müssen die dosimetrischen Auswirkungen und die Eignung für die Bestrahlungsplanung bewerten, begleitet von einer angemessenen klinischen Validierung.
„Bildähnlichkeit allein belegt noch keine klinische Verlässlichkeit.“
Ciro Benito Raggio, Institut für Biomedizinische Technik des KIT
Wie realistisch Angriffe auf das gemeinsame Modell sind
Sie haben geprüft, ob sich aus einem trainierten Modell Bilddaten einzelner Patientinnen und Patienten rekonstruieren lassen. Wie realistisch sind solche Angriffe heute? Welche Anpassungen haben zur Abwehr gereicht?
Diesen wichtigen Aspekt haben wir selbstverständlich ebenfalls untersucht. Wegen der sensiblen Daten und der in der Fachliteratur beschriebenen Risiken haben wir geprüft, ob sich während und nach dem föderierten Training Informationen über Patientinnen und Patienten ableiten lassen. Dabei muss man verschiedene Arten von Angriffen unterscheiden. Manche versuchen, Trainingsdaten aus Gradienten oder Modell-Updates zu rekonstruieren. Andere wollen herausfinden, ob die Daten einer bestimmten Person im Trainingsdatensatz enthalten waren. Ob solche Angriffe machbar und wirksam sind, hängt vom Szenario, von den Informationen des Angreifers und von der Konfiguration des Systems ab.
In unserer Arbeit haben wir mehrere Angriffsarten und die passenden Gegenmaßnahmen untersucht. Dabei haben wir auch bewertet, wie sie sich auf die Erzeugung synthetischer CT-Bilder auswirken.
Die Gradient Inversion Attack versucht, Trainingsbeispiele aus Gradienten oder aus Informationen über die Modell-Updates zu rekonstruieren. In unserer Versuchskonfiguration blieb diese Bildrekonstruktion wirkungslos. Das deckt sich mit früheren Studien. Sie zeigen, dass bestimmte Merkmale des Trainings solche Angriffe erschweren können, darunter Batch-Normalisierung und Batches mit mehreren Bildern.
Außerdem haben wir Aggregationsstrategien auf Basis des Medians statt des Mittelwerts betrachtet. Sie begrenzen den Einfluss manipulierter Updates, die das gemeinsame Training kompromittieren könnten.
Gegen Inferenzangriffe haben wir Verfahren zur sicheren Aggregation untersucht, etwa Secure Aggregation nach Bonawitz und Kollegen aus dem Jahr 2017. Damit erhält der Server ein zusammengeführtes Ergebnis, ohne direkt auf die Beiträge der einzelnen Teilnehmer zuzugreifen. Das gilt im Rahmen der Sicherheitsannahmen des Protokolls.
Insgesamt zeigen unsere Experimente, wie wichtig es ist, die Sicherheit des föderierten Systems zu prüfen. Man sollte nicht einfach annehmen, dass dezentral gehaltene Daten für sich genommen schon die Privatsphäre garantieren. Zudem adressieren verschiedene Gegenmaßnahmen verschiedene Risiken. Sie müssen deshalb gegen die jeweils betrachteten Bedrohungen bewertet werden.
Eingefrorene Schichten sparen Rechenzeit und Strom
Je nach Modellarchitektur sanken Rechenaufwand und CO₂-Emissionen um 9 bis 23 Prozent. Woher kommt die Einsparung? Was bedeutet sie für kleinere Kliniken mit wenig Rechenkapazität?
Die Einsparungen entstehen, weil wir den Trainingsprozess mit einer adaptiven Strategie zum Einfrieren von Netzwerkschichten optimiert haben. Vereinfacht gesagt: Wenn bestimmte Teile des föderierten Modells von einer Trainingsrunde zur nächsten ausreichend stabil sind, müssen die Clients sie nicht mehr in jeder Runde aktualisieren. In unserer Studie war das der Encoder des Netzes. Das senkt den nötigen Rechenaufwand.
Adaptiv ist unsere Strategie, weil sie dynamisch bestimmt, wann diese Schichten eingefroren werden. Je nach Architektur und Trainingsverlauf kann die Stabilität zu unterschiedlichen Zeitpunkten erreicht sein.
Der Nutzen hängt von der verwendeten Architektur ab. Wir haben mehrere Deep-Learning-Modelle mit unterschiedlichen Strukturen und Rechenkosten getestet, deshalb fielen die Einsparungen nicht in jedem Fall gleich aus. Zudem sollte unsere Studie vor allem zeigen, dass die vorgeschlagene Methode funktioniert. Alle Parameter für jede Architektur einzeln zu optimieren, war nicht das Ziel. Weitere Experimente, die gezielt auf einzelne Architekturen zugeschnitten sind, könnten deshalb zusätzliche Verbesserungen bringen.
Weniger Trainingszeit und Energieverbrauch könnten die föderierte Zusammenarbeit für Kliniken mit begrenzten Rechenressourcen zugänglicher machen. Das gilt auch für Häuser, die auf externe Rechenressourcen mit nutzungsabhängiger Abrechnung angewiesen sind.
Das ist ein kleiner Beitrag zu einer effizienteren und verantwortungsvolleren medizinischen KI. Angemessene Hardware für die vorgeschlagenen Lösungen braucht es trotzdem weiterhin.
Was bis zur klinischen Praxis noch fehlt
Was fehlt noch auf dem Weg in die klinische Praxis, etwa bei Validierung, Zulassung oder IT-Infrastruktur?
Für den Schritt von der Forschung in die klinische Praxis muss man zweierlei zeigen: Föderiertes Lernen ist bei Bedarf eine tragfähige Alternative zum zentralen Training. Und die erzeugten synthetischen CT-Bilder sind für ihren vorgesehenen Einsatz ausreichend genau und sicher.
In der Strahlentherapie heißt das: Neben den üblichen Metriken zur Bildqualität muss bewertet werden, wie sich die Bilder auf die Dosisberechnung und die Bestrahlungsplanung auswirken. Diese Prüfung ist auch für Verfahren wichtig, die synthetische CT-Bilder mit zentralem Training erzeugen. Die visuelle Bildqualität allein reicht nicht aus, um die Eignung für den klinischen Einsatz zu belegen.
Technisch muss das System in die vorhandene Infrastruktur der Kliniken eingebunden werden. Die Kommunikation muss abgesichert sein. Außerdem braucht es Verfahren für Updates, Zugriffsrechte und die Aufteilung der Verantwortung zwischen den beteiligten Einrichtungen. Zu prüfen ist auch, ob die Infrastruktur zuverlässig genug ist, um das Training und die laufende Pflege des Modells zu tragen.
Regulatorisch kann es den Bedarf an Übermittlungen personenbezogener Daten verringern, wenn die Daten in den einzelnen Kliniken bleiben. Das hebt aber nicht automatisch alle Pflichten auf, die den Datenschutz und den Einsatz medizinischer Software betreffen. Welcher Weg zur Konformität gilt, muss deshalb für die konkrete Lösung bewertet werden, abhängig von ihrer Zweckbestimmung und regulatorischen Einstufung. Gleichzeitig müssen die Verantwortlichkeiten der beteiligten Einrichtungen geklärt werden.
Unsere Arbeit trägt zur Entwicklung und Bewertung dieser Methode in der Strahlentherapie bei. Für den klinischen Einsatz sind aber weitere technische, klinische und regulatorische Prüfungen nötig.
Vom Smartphone bis zur Bank: Wo der Ansatz noch passt
Lässt sich der Ansatz auf andere Bereiche übertragen, in denen sensible Daten verteilt liegen, etwa auf Unternehmen und Behörden?
Ja, das ist möglich. Die ersten Anwendungen des föderierten Lernens stammen aus den Jahren 2016 und 2017: die Vorhersage des nächsten Worts und Suchvorschläge auf Smartphones. Heute wird föderiertes Lernen im Finanz- und Bankwesen sowie beim autonomen Fahren eingesetzt. Im Gesundheitswesen hat es viele Anwendungen gefunden, darunter die Wirkstoffentdeckung, die Klassifikation und Segmentierung von Tumoren sowie die Bildsynthese.
Föderiertes Lernen kann immer dann nützlich sein, wenn verschiedene Organisationen gemeinsam ein KI-Modell entwickeln wollen, ihre Daten aber nicht zentral zusammenführen können oder wollen. Gründe dafür sind Datenschutz, Vertraulichkeit oder regulatorische Vorgaben. Gerade diese Möglichkeit, zusammenzuarbeiten, ohne die Originaldaten zwingend zu übertragen, macht den Ansatz auch für das Gesundheitswesen attraktiv.
Natürlich löst föderiertes Lernen nicht automatisch jede Herausforderung bei Sicherheit und Governance. Angemessene Zugriffskontrollen, der Schutz der Modell-Updates, Vereinbarungen zwischen den Beteiligten und auf die jeweilige Branche zugeschnittene Risikobewertungen bleiben notwendig.
Die Ergebnisse der Forschungsgruppe sind in vier Fachartikeln erschienen: zur föderierten MRT-zu-CT-Synthese am Gehirn in Computers in Biology and Medicine, zur Übersetzung von CBCT- in synthetische CT-Bilder im Kopf-Hals-Bereich in Frontiers in Digital Health, zur Sicherheitsanalyse im Journal of Medical Systems sowie zum energieeffizienten Training in Sustainable Computing: Informatics and Systems.
Häufige Fragen
Was ist föderiertes Lernen?
Föderiertes Lernen ist ein Trainingsverfahren für KI-Modelle, bei dem die Daten bei den beteiligten Einrichtungen bleiben. Jede Einrichtung trainiert lokal und schickt nur Aktualisierungen der Modellparameter an einen Server. Der Server fasst sie zusammen und schickt das aktualisierte Modell für die nächste Trainingsrunde an alle zurück.
Wofür braucht die Strahlentherapie synthetische CT-Bilder?
CT-Aufnahmen sind unter anderem für die Berechnung der Strahlendosis nötig. KI-Modelle können CT-Bilder aus MRT- oder CBCT-Aufnahmen erzeugen. Laut KIT könnten solche Bilder künftig in bestimmten Anwendungsfällen zusätzliche CT-Aufnahmen ersetzen und damit die Belastung durch weitere Röntgenstrahlung senken.
Ist föderiertes Lernen automatisch datenschutzkonform?
Nein. Bleiben die Daten in den Kliniken, kann das Übermittlungen personenbezogener Daten verringern. Die Pflichten zum Datenschutz und zum Einsatz medizinischer Software entfallen dadurch nicht automatisch. Zudem beschreibt die Fachliteratur Angriffe, die Informationen über Patientinnen und Patienten ableiten sollen. Deshalb braucht auch das föderierte System eine eigene Sicherheitsprüfung.
Wie spart das Verfahren des KIT Rechenaufwand?
Eine adaptive Strategie friert Teile des Modells ein, sobald sie von Runde zu Runde stabil genug sind, im untersuchten Fall den Encoder. Die Kliniken müssen diese Teile dann nicht mehr in jeder Runde aktualisieren. Wie viel das bringt, hängt von der Modellarchitektur ab. Laut KIT blieb die Qualität der synthetischen Bilder dabei erhalten.
Wo wird föderiertes Lernen außerhalb der Medizin eingesetzt?
Die ersten Anwendungen aus den Jahren 2016 und 2017 betrafen Wortvorhersage und Suchvorschläge auf Smartphones. Heute nutzen unter anderem das Finanz- und Bankwesen sowie das autonome Fahren den Ansatz.
Lesetipps der Redaktion
cloudmagazinScope-3-Cloud: Kosten und Emissionen koppelncloudmagazinWenn KI-Agenten reisen: Data-Residency als Operating-ProblemcloudmagazinPlug & Heal: Wie Plattformen und Ökosysteme Gesundheitslösungen in die Versorgung bringenMehr aus dem MBF Media Netzwerk
MyBusinessFutureDiGA und ePA werden zum IT-TestfallDigital ChiefsKI-Diagnostik: Haftungsfragen bei fehlerhaften AlgorithmenSecurityTodayHealthcare-Datenleak: 96 Stunden bis zur MeldungBildquelle: KI-generiert (Oktober 2026)


