EKS 1.36 se vuelve costoso si falta la disciplina FinOps
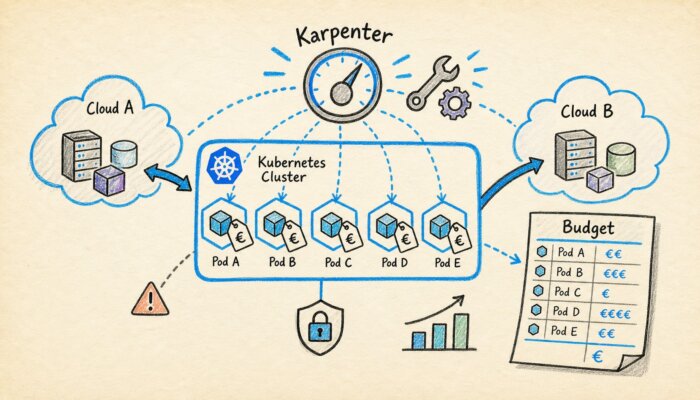
EKS 1.36 pospone la cuestión de los costes a la plataforma. La asignación por pod, el contrato NodePool y la asignación multicloud son ahora tareas del…
7 min. de lectura
EKS 1.36 eleva la cuestión de los costes un nivel más: ya no se trata solo de la eficiencia de los nodos, sino de la asignación por carga de trabajo. Quien no integre esto ahora en la plataforma, acabará pagando facturas de nube que, en el próximo trimestre, nadie podrá explicar con claridad.
Lo más importante en resumen
- Los costes migran a la plataforma. Con EKS 1.36, la asignación por pod y por equipo se convierte en una responsabilidad de la plataforma. Quien intente delegarlo en el departamento financiero, no superará la auditoría.
- Karpenter ya no es un simple complemento para ahorrar. A partir de esta oleada de versiones, la política de NodePool determinará si un equipo asume el riesgo de las instancias Spot o paga la prima de On-Demand. Esto es una cuestión contractual, no de herramientas.
- La multi-nube agrava el problema. Quien opere EKS junto a AKS o GKE tendrá tres modelos de asignación que no podrán unificarse en una única visión de FinOps. La plataforma debe traducirlos, o cada equipo empezará a competir financieramente contra los demás.
Relacionado:FinOps para inferencia de IA / Un operador logístico ahorra un 31 % en costes de multi-nube
Lo que cambia en la cuestión de los costes con EKS 1.36
¿Qué es EKS 1.36? Amazon Elastic Kubernetes Service en la línea de versiones 1.36 es el servicio de Kubernetes gestionado en AWS que refleja la versión 1.36 de Kubernetes. Lo novedoso no es solo el conjunto de funciones upstream, sino la estrecha integración de Karpenter, Split Cost Allocation Data y Container Insights, que hacen auditables los costes a nivel de pod directamente desde el clúster.
Si se consulta la consola de GSC para ver qué han buscado los equipos de plataforma en las últimas semanas, se encuentra «eks 1.36» varias veces entre las principales consultas. No se trata de un interés por las notas de la versión. Quien escribe este término ya tiene un clúster en producción y quiere saber qué cambia en la visión de costes.
La respuesta corta: AWS ha ido incorporando Cost Allocation Tags, Split Cost Allocation Data y Container Insights con métricas a nivel de pod a la plataforma EKS a lo largo de varias versiones. EKS 1.36 es el momento en que estas piezas encajan. Antes eran rutas separadas con modelos de datos independientes. Ahora convergen en una única visión que los equipos de plataforma deben curar ellos mismos.
Esto cambia las responsabilidades. Hasta ahora, el equipo de plataforma podía decir: nosotros entregamos el clúster, FinOps aporta la visión. Con la 1.36, esto se invierte. Quien opera el clúster también es responsable de la asignación de costes, ya que las etiquetas, las etiquetas de pod y la pipeline de informes dependen de la plataforma, no de la herramienta financiera.
Tres palancas que los equipos de plataforma ajustan ahora
En primer lugar: convención de etiquetado. Sin etiquetas continuas en Cluster, NodePool, Namespace y Pod, no hay asignación. Quien aún no tenga esto en 2026 tendrá que reconstruir la visión en cada ejecución de informes. Una convención es suficiente, pero debe imponerse, idealmente con políticas de OPA o Kyverno.
En segundo lugar: estrategia de NodePool. Karpenter está estable desde la versión 1.0 y se recomienda por defecto en EKS 1.36. Un NodePool decide si una carga de trabajo se ejecutará en Spot o On-Demand, qué familia de instancias recibirá y si se permite Graviton. Si esta decisión se deja al equipo de aplicaciones, no habrá historia de costes de plataforma. Si se toma de forma centralizada, se genera fricción. Ambos son aceptables, pero debe ser explícito.
En tercer lugar: asignación a nivel de Pod. AWS Split Cost Allocation Data distribuye los costes de EC2 proporcionalmente entre Pods. Esto solo funciona si las solicitudes de recursos están correctamente definidas. En la mayoría de los clústeres no es así. Los Pods se ejecutan con solicitudes predeterminadas, que pueden ser demasiado altas o demasiado bajas, y la asignación se vuelve inutilizable. Antes de la historia de costes, viene un auditoría de solicitudes.
Karpenter pasa de ventaja fiscal a instrumento de control de costes
Durante los primeros años de Karpenter, el objetivo fue reemplazar al Cluster Autoscaler y escalar más rápido. Eso ya se ha hecho. Lo que importa ahora es la disciplina de los NodePools. Un NodePool es un contrato entre la plataforma y el equipo: qué tipos de instancia, qué zona de disponibilidad, qué porcentaje de Spot, qué tolerancia a interrupciones.
Quien lo agrupa todo en una única NodePool no tiene control. Quien crea una NodePool por equipo tiene demasiada complejidad. Lo realista es tener entre tres y cinco NodePools por clúster productivo: uno para cargas de trabajo estáticas y de larga duración, otro para cargas de trabajo de tipo batch con Spot, otro para inferencia de GPU, opcionalmente uno para Pods aislados por cumplimiento.
Con esto, la definición del NodePool se convierte en una decisión FinOps que aparece en el manifiesto del clúster. Es auditable, versionada y se encuentra en el mismo repositorio que el resto de la configuración de la plataforma. Este es el punto donde la gobernanza de costes se vuelve técnica y ya no solo se gestiona en un dashboard.
Lo que hace Multi-Cloud con la factura de EKS
Multi-Cloud suena para Finanzas como una dispersión de riesgos. Para la plataforma es un problema de allokación. EKS factura de forma diferente a AKS, AKS factura de forma diferente a GKE y ninguna de las tres perspectivas se puede mapear sin adaptador a la otra.
| Dimensión de allokación | EKS 1.36 | AKS 1.32 | GKE 1.34 |
|---|---|---|---|
| Costos por nivel de pod | Asignación de datos de costo nativa | Análisis de costos por espacio de nombres | Asignación de costos GKE, basada en etiquetas |
| Control de spots | NodePool de Karpenter | Pools de nodos Spot | Provisión automática de nodos con Spot |
| Herencia de etiquetas | Etiquetas de Kubernetes mapeadas a etiquetas de AWS | Etiquetas de Azure mediante Cluster Autoscaler | Etiquetas nativas en el Billing de GCP |
| Latencia del informe | 24 horas | 12 a 24 horas | Hasta 48 horas |
Fuente: Documentación de los proveedores, mayo 2026, propia evaluación.
Quien opera tres nubes simultáneamente necesita una capa de traducción. Esta puede ser asumida por un herramienta como Kubecost o OpenCost, también puede ser una pipeline propia que convierta las tres APIs de costos en un esquema común. Lo que no funciona: permitir a cada equipo su propia convención de nube y construir al final un Excel.
Allokación: quién paga por qué pod
La pregunta difícil en cada programa FinOps no es la suma, sino la distribución. Un clúster que es utilizado por cuatro equipos tiene un operador de clúster y cuatro consumidores. El operador paga por la Control Plane, Networking y servicios compartidos. Los consumidores pagan por sus pods.
Esto suena sencillo. En la práctica, tres cosas colapsan: los pods sin etiquetas limpias no se asignan. Los servicios compartidos como Ingress Controller o Service Mesh se cuentan dos veces. Las recursos ociosos no se distribuyen. Una allokación que no regule estos tres puntos no es política, sino una factura.
El camino pragmático: los pods sin etiqueta de equipo terminan en un «bucket de plataforma» y se revisan mensualmente. Los servicios compartidos se distribuyen proporcionalmente según el consumo de CPU. La capacidad ociosa se reparte entre el equipo que causó las Reserved Instances o Savings Plans. Esto no es perfecto, pero es explicativo.
Lo que debe cambiar en el contrato de plataforma ahora
Un equipo de plataforma que opera EKS 1.36 en producción en 2026 tiene un contrato diferente con la organización que hace dos años. Antes, la pregunta era: ¿Puedes darnos un cluster que funcione? Ahora es: ¿Puedes decirnos cuánto cuesta y quién lo paga?
Esto requiere tres cosas en el catálogo de servicios. Primero, una convención de etiquetado que se considera requisito previo para el onboarding. Segundo, una selección de NodePool que el equipo debe tomar activamente y que está claramente descrita con sus implicaciones de coste. Tercero, un informe mensual de costes que esté sobre la mesa de Finanzas y no solo cuando el CFO lo pregunte.
Quien logre esto tiene una plataforma. Quien no lo logre tiene una colección de clusters con una factura desconocida. EKS 1.36 hace visible técnicamente la diferencia. La decisión de adoptarla también a nivel organizacional recae en los equipos de plataforma.
Preguntas frecuentes
¿Necesito Kubecost para asignar limpiamente los costes de EKS?
No, pero la tarea se vuelve más compleja al construirlo por cuenta propia. AWS Split Cost Allocation Data más las etiquetas de asignación de costes son suficientes para la mayoría de los escenarios de un solo cluster. Tan pronto como haya más de tres clusters o se involucre Multi-Cloud, vale la pena usar una herramienta como Kubecost, OpenCost o una capa similar. Los costes de las herramientas en sí suelen ser significativamente más bajos que las horas que un equipo invierte en sus propias pipelines.
¿Cómo se comporta Karpenter con las Reserved Instances y los Savings Plans?
Karpenter utiliza automáticamente Reserved Instances y Savings Plans cuando están disponibles en la misma familia de instancias. Sin embargo, prefiere las Spot-Instances más económicas, lo que, con una política de Spot agresiva, hace que los Savings Plans no se aprovechen al máximo. Quien compra Savings Plans durante varios años debería definir NodePools con capacidad solo On-Demand que absorban estos planes y permitir Spot solo donde el workload sea tolerante a interrupciones.
¿Qué ocurre con la asignación de costes cuando un Pod corre en varios Namespaces?
Un Pod siempre corre en un solo Namespace. Lo que se quiere decir es: Si un workload usa recursos de múltiples Namespaces como volúmenes compartidos, servicios comunes o bases de datos centrales, la asignación debe representar esta conexión cruzada. Enfoque pragmático: Los recursos de múltiples Namespaces se colocan en un ‘Shared-Services’-Bucket, que se distribuye a los consumidores según una clave claramente definida (consumo de CPU, número de solicitudes). Quien no lo regule pierde del 10 al 20 por ciento de los costes en una asignación no clara.
¿Vale la pena EKS 1.36 para un cluster pequeño con tres equipos?
El camino de actualización a 1.36 vale la pena para cualquier cluster productivo, solo por las actualizaciones de seguridad y la política de ciclo de vida de AWS. Las características de FinOps son un beneficio, no un impulsor. Para tres equipos suele bastar un único NodePool con una tolerancia a Spot claramente definida, un esquema de etiquetas coherente y una exportación mensual de costes. El paquete completo de FinOps se requiere para clusters con cinco equipos o carga combinada de cómputo superior a 200.000 Euro al año.
Imagen de portada: Generada por IA (mayo 2026)
Fuente de imagen: Generada por IA (mayo 2026), certificado C2PA incluido en la imagen
Traducido del original en alemán con inteligencia artificial. La versión alemana es la de referencia.


