EKS 1.36 sera coûteux si la discipline FinOps fait défaut
EKS 1.36 déplace la question des coûts vers la plateforme. L'allocation par Pod, le contrat de NodePool et la cartographie multi-cloud sont maintenant…
7 Min. Temps de lecture
EKS 1.36 déplace la question des coûts d’un étage : plus seulement l’efficacité des nœuds, mais l’allocation par charge de travail. Quiconque ne l’ancre pas maintenant dans la plateforme paiera avec des factures de cloud qui ne pourront plus être expliquées proprement au prochain trimestre.
Les points clés en bref
- Les coûts migrent vers la plateforme. Avec EKS 1.36, l’allocation par pod et par équipe devient une tâche de la plateforme. Quiconque reporte cela sur la finance ne passera pas l’audit.
- Karpenter n’est plus un plugin d’économie. À partir de cette vague de versions, la politique de NodePool décide si une équipe supporte le risque Spot ou le supplément On-Demand. C’est une question de contrat, pas de tooling.
- Le multi-cloud aggrave le problème. Quiconque exécute EKS à côté d’AWS ou de GKE a trois modèles d’allocation qui ne peuvent pas être ramenés à une vue FinOps. La plateforme doit traduire cela, sinon chaque équipe comptera contre les autres.
Lié :FinOps pour l’inférence de l’IA / Un logisticien économise 31 % de coûts de cloud multi-cloud
Ce qui change avec EKS 1.36 dans la question des coûts
Qu’est-ce qu’EKS 1.36 ? Amazon Elastic Kubernetes Service dans la ligne de versions 1.36 est le service Kubernetes géré sur AWS qui reflète la version Kubernetes 1.36. Ce qui est nouveau, ce n’est pas seulement l’ensemble de fonctionnalités upstream, mais l’étroite imbrication de Karpenter, des données d’allocation de coûts fractionnées et de Container Insights, qui rendent les coûts au niveau du pod directement audités à partir du cluster.
Quiconque regarde dans la console GSC ce que les équipes de plateforme ont recherché ces dernières semaines, trouve « eks 1.36 » plusieurs fois dans les principales requêtes. Ce n’est pas un intérêt pour les notes de version. Quiconque tape le terme a déjà un cluster en fonctionnement et veut savoir ce qui change dans la vue des coûts.
La réponse courte : AWS a poussé les étiquettes d’allocation de coûts, les données d’allocation de coûts fractionnées et Container Insights avec des métriques au niveau du pod dans la plateforme EKS sur plusieurs versions. EKS 1.36 est le moment où ces éléments s’emboîtent. Auparavant, c’étaient des chemins séparés avec des modèles de données séparés. Maintenant, ils atterrissent dans une vue que les équipes de plateforme doivent elles-mêmes curer.
Cela change la responsabilité. Jusqu’à présent, l’équipe de plateforme pouvait dire : Nous fournissons le cluster, FinOps fournit la vue. Avec 1.36, cela bascule. Quiconque exploite le cluster est également responsable de l’allocation des coûts, car les étiquettes, les étiquettes de pod et la pipeline de reporting sont liés à la plateforme et non à l’outil de finance.
Trois éléments à ajuster pour les équipes de plateformes
Premièrement : convention de tagging. Sans tags cohérents sur les clusters, les NodePools, les namespaces et les pods, aucune allocation n’est possible. Si vous n’avez pas mis en place cela en 2026, vous reconstruirez la vue à chaque exécution de rapport. Une convention suffit, mais elle doit être appliquée, idéalement avec des politiques OPA ou Kyverno.
Deuxièmement : stratégie de NodePool. Karpenter est stable depuis la version 1.0 et est recommandé par défaut dans EKS 1.36. Un NodePool décide si une charge de travail s’exécute sur Spot ou à la demande, quelle famille d’instances elle obtient et si Graviton est autorisé. Si cette décision est laissée à l’équipe d’applications, il n’y a pas d’histoire de coûts de plateforme. Si elle est prise de manière centralisée, il y a des frictions. Les deux sont acceptables, mais cela doit être explicite.
Troisièmement : allocation au niveau du pod. Les données d’allocation de coûts EC2 réparties par AWS Split Cost Allocation Data ne fonctionnent que si les demandes de ressources sont correctement configurées. Dans la plupart des clusters, ce n’est pas le cas. Les pods s’exécutent avec des demandes par défaut trop élevées ou trop basses, et l’allocation devient inutilisable. Avant l’histoire des coûts, il y a donc un audit des demandes.
Karpenter devient un instrument de contrôle plutôt qu’un simple avantage d’économie
Dans les premières années de Karpenter, l’objectif était de remplacer le Cluster-Autoscaler et d’accélérer la montée en charge. C’est chose faite. Ce qui compte maintenant, c’est la discipline des NodePools. Un NodePool est un contrat entre la plateforme et l’équipe : quels types d’instances, quelle zone de disponibilité, quelle proportion de Spot, quelle tolérance aux perturbations.
Si vous regroupiez tout dans un seul NodePool, vous n’avez pas de contrôle. Si vous construisez un NodePool par équipe, vous avez trop de complexité. De manière réaliste, il y a trois à cinq NodePools par cluster productif : un pour les charges de travail statiques à long terme, un pour les charges de travail Spot capables de traitement par lots, un pour l’inférence GPU, et éventuellement un pour les pods isolés pour des raisons de conformité.
La définition du NodePool est ainsi une décision FinOps qui figure dans le manifeste du cluster. Elle est auditable, versionnée et se trouve dans le même référentiel que le reste de la configuration de la plateforme. C’est le point où la gouvernance des coûts devient technique et ne se limite plus à un tableau de bord.
Ce que le multi-cloud fait avec la facturation EKS
Le multi-cloud ressemble à une diversification des risques pour la finance. Pour la plateforme, c’est un problème d’allocation. EKS facture différemment d’AKS, AKS facture différemment de GKE, et aucune des trois vues ne peut être mappée sur les autres sans adaptateur.
| Dimension d’allocation | EKS 1.36 | AKS 1.32 | GKE 1.34 |
|---|---|---|---|
| Coûts au niveau du pod | Données d’allocation des coûts fractionnés de manière native | Analyse des coûts par namespace | Allocation des coûts GKE, basée sur les étiquettes |
| Gestion des spots | Karpenter NodePool | Pools de nœuds Spot | Provisionnement automatique de nœuds avec Spot |
| Héritage des étiquettes | Étiquettes Kubernetes mappées sur les étiquettes AWS | Étiquettes Azure via Cluster Autoscaler | Étiquettes natives dans la facturation GCP |
| Latence des rapports | 24 heures | 12 à 24 heures | Jusqu’à 48 heures |
Source : documentation des fournisseurs, état en mai 2026, évaluation propre.
Lorsqu’on utilise trois clouds en parallèle, il est nécessaire d’avoir une couche de traduction. Celle-ci peut être assurée par un outil tel que Kubecost ou OpenCost, ou également par une pipeline construite en interne qui rassemble les trois API de coût sur un schéma commun. Ce qui ne fonctionne pas : permettre à chaque équipe d’avoir sa propre convention cloud et construire un Excel à la fin du mois.
Allocation : qui paie pour quel pod
La question difficile dans chaque programme FinOps n’est pas la somme, mais la répartition. Un cluster utilisé par quatre équipes a un opérateur de cluster et quatre consommateurs. L’opérateur paie pour le plan de contrôle, le réseau et les services partagés. Les consommateurs paient pour leurs pods.
Cela semble simple. En pratique, trois choses s’effondrent : les pods sans étiquettes propres ne sont pas attribués. Les services partagés tels que les contrôleurs d’entrée ou les réseaux de services sont comptés deux fois. Les ressources inactives ne sont pas réparties. Une allocation qui ne réglemente pas ces trois points est une politique, pas une facturation.
Le chemin pragmatique : les pods sans étiquette d’équipe atterrissent dans un « bac de plateforme » et sont renégociés mensuellement. Les services partagés sont répartis proportionnellement à la consommation de CPU. La capacité inactive est répartie entre les équipes qui ont causé les instances réservées ou les plans d’épargne. Ce n’est pas parfait, mais c’est explicable.
Ce qui doit changer dans le contrat de plateforme maintenant
Une équipe de plateforme qui exploite EKS 1.36 de manière productive en 2026 a un contrat différent avec l’organisation qu’il y a deux ans. À l’époque, la question était : Pouvez-vous nous donner un cluster qui fonctionne ? Aujourd’hui, elle est : Pouvez-vous nous dire ce qu’il coûte et qui le paie ?
Cela nécessite trois choses dans le catalogue de services. Premièrement, une convention de tagging qui s’applique comme condition d’intégration. Deuxièmement, une sélection de NodePool que l’équipe doit faire activement et qui est clairement décrite avec des implications de coût. Troisièmement, un rapport de coût mensuel qui est sur la table de la finance et non seulement lorsque le directeur financier demande.
Qui obtient cela, a une plateforme. Qui n’y arrive pas, a une collection de clusters avec une facture inconnue. EKS 1.36 rend la différence techniquement visible. La décision de la tirer également organisationnellement appartient aux équipes de plateforme.
Foire aux questions
Ai-je besoin de Kubecost pour allouer proprement les coûts EKS ?
Non, mais la tâche devient plus compliquée avec une construction propre. Les données d’allocation de coûts AWS Split et les tags d’allocation de coûts suffisent pour la plupart des scénarios de cluster unique. Dès que plus de trois clusters ou de multi-cloud sont impliqués, un outil comme Kubecost, OpenCost ou une couche similaire en vaut la peine. Les coûts des outils eux-mêmes sont généralement nettement inférieurs aux heures qu’une équipe passe dans ses propres pipelines.
Comment Karpenter se comporte-t-il avec les instances réservées et les plans d’économie ?
Karpenter utilise automatiquement les instances réservées et les plans d’économie s’ils sont disponibles sur la même famille d’instances. Mais il préfère les instances Spot bon marché, ce qui conduit à une politique Spot agressive qui fait que les plans d’économie ne sont pas pleinement utilisés. Qui achète des plans d’économie sur plusieurs années devrait définir des NodePools avec une capacité On-Demand uniquement qui absorbent ces plans et n’autorise Spot que là où la charge de travail est tolérante aux perturbations.
Qu’arrive-t-il à l’allocation de coûts si un pod s’exécute dans plusieurs espaces de noms ?
Un pod s’exécute toujours dans un seul espace de noms. Ce qui est visé : si une charge de travail utilise des ressources Cross-Namespace comme des volumes partagés, des services communs ou des bases de données centrales, l’allocation doit refléter cette connexion transversale. Voie pragmatique : les ressources Cross-Namespace vont dans un bucket « Services partagés » qui est réparti sur les consommateurs selon une clé clairement définie (consommation de CPU, nombre de requêtes). Qui ne réglemente pas cela, perd 10 à 20 pour cent des coûts dans une attribution peu claire.
L’EKS 1.36 en vaut-il la peine pour un petit cluster avec trois équipes ?
Le chemin de mise à niveau vers 1.36 en vaut la peine pour chaque cluster productif, ne serait-ce que pour les correctifs de sécurité et la politique de cycle de vie d’AWS. Les fonctionnalités FinOps sont un bonus, pas un moteur. Pour trois équipes, une seule NodePool avec une tolérance Spot clairement définie, un schéma d’étiquetage cohérent et un export de coût mensuel suffisent souvent. L’appareil FinOps complet est nécessaire pour les clusters de cinq équipes ou de charge de travail informatique combinée de plus de 200 000 euros par an.
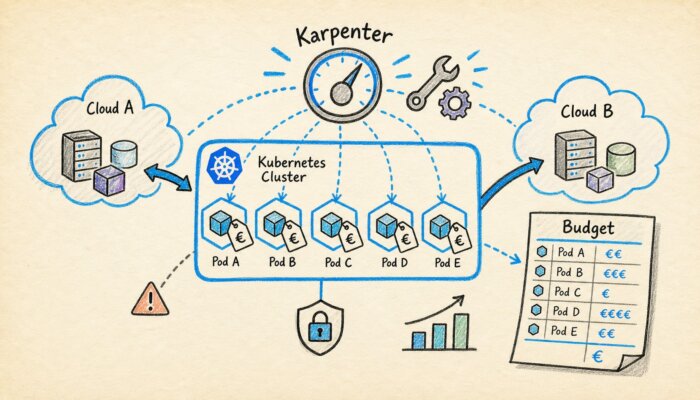
Image de titre : générée par IA (mai 2026)
Source de l’image : générée par IA (mai 2026), certificat C2PA intégré dans l’image
Traduit de l’original allemand par intelligence artificielle. La version allemande fait foi.


