Kubernetes réduit les coûts du cloud dans les PME
FinOps avec Kubernetes dans les PME : le dimensionnement approprié, l'auto-échelonnement et le showback rendent les coûts de cluster gérables plutôt que…
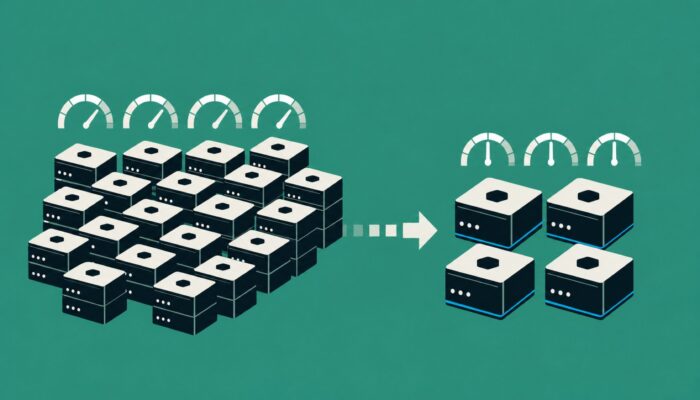
La facture cloud augmente, mais l’utilisation des clusters n’est que de 30 %. Ce déséquilibre est la norme dans de nombreux environnements Kubernetes du Mittelstand. Pour réduire les coûts, il faut agir un niveau en dessous du tableau de bord de facturation : au niveau des requests, des limites et de la densité réelle des workloads.
Les points clés en bref
- Le rightsizing est le levier le plus puissant : des requests surdimensionnés réservent une capacité jamais exploitée. Les ajuster à la demande réelle réduit la facture sans perte de performance.
- L’autoscaling rend les coûts dynamiques : le scaling horizontal et vertical adapte les ressources à la charge, évitant de payer en permanence pour un pic théorique.
- Sans showback, pas de changement de comportement : seul un affichage des coûts par microservice par équipe crée l’incitation à optimiser l’architecture.
Articles associés :Réduire de 30 % les coûts cloud / Le processeur cloud économique
Pourquoi le tableau de bord des hyperscalers ne montre pas tout
Le tableau de bord de facturation d’un hyperscaler indique le coût d’une instance, mais pas si cette instance tourne à vide aux trois quarts. Dans un cluster Kubernetes, c’est précisément là que se cache l’argent : les nœuds sont facturés en fonction des requests réservés par les pods, et non de leur utilisation réelle. Qui surestime ses requests pour se prémunir des risques paie cette sécurité 24 heures sur 24.
La première étape consiste donc à obtenir une transparence au niveau des pods. Les métriques d’utilisation réelle du CPU et de la mémoire, comparées aux requests définis, révèlent les écarts. En pratique, l’utilisation moyenne de nombreux clusters est bien inférieure à la moitié de la capacité réservée. Ce n’est pas une exception, mais le point de départ de toute optimisation sérieuse.
Trois leviers Kubernetes pour une réduction réelle des coûts
Le rightsizing arrive en tête. Les requests et limites sont ajustés à l’usage mesuré, avec une marge réaliste pour les pics de charge. Le Vertical Pod Autoscaler fournit des recommandations à observer d’abord en mode simulation, avant d’être appliquées en production.
Le deuxième levier est l’Horizontal Pod Autoscaler. Au lieu de maintenir un nombre fixe de réplicas pour un pic hypothétique, il ajuste le nombre de pods en fonction de la CPU, de la mémoire ou de métriques personnalisées. Le troisième levier concerne les nœuds : un Cluster Autoscaler éteint les nœuds inutilisés dès que les pods n’en ont plus besoin. Ensemble, ces trois outils permettent à la capacité réservée de suivre la charge réelle.
Configurer le bin packing et les quotas de ressources
Le bin packing désigne la densité avec laquelle le planificateur répartit les pods sur les nœuds disponibles. Un planificateur optimisé pour l’utilisation regroupe les workloads de manière plus serrée et réduit ainsi le nombre total de nœuds nécessaires. Cela diminue significativement les coûts fixes, mais exige des requests précis pour éviter la surréservation d’un nœud.
Les quotas de ressources fixent des garde-fous par namespace. Ils empêchent une équipe d’accaparer discrètement des ressources et d’alourdir la facture du cluster entier. Pour le Mittelstand, avec ses quelques clusters partagés, les quotas sont le moyen le plus simple d’imposer une discipline budgétaire, sans avoir à la négocier en réunion.
Quand le Bare-Metal est moins cher que le Cloud public
Tous les workloads ne sont pas adaptés au Cloud public. Pour les charges de travail constantes et prévisibles, une infrastructure Bare-Metal en propriété ou en location peut s’avérer moins coûteuse sur la durée que la facturation horaire d’un hyperscaler. L’élasticité du Cloud représente un surcoût inutile lorsque la charge de base est régulière.
Le calcul honnête doit inclure l’ensemble des coûts, y compris l’exploitation, et pas seulement le prix du calcul. Une approche pragmatique consiste à séparer les charges : la charge de base constante sur une capacité permanente et bon marché, les pics élastiques dans le Cloud public. Kubernetes rend cette répartition techniquement réalisable, car les mêmes workloads peuvent fonctionner sur les deux environnements.
Showback par microservice avec Kubecost
Une optimisation sans attribution claire reste sans effet. Des outils comme Kubecost détaillent les coûts des clusters jusqu’aux namespaces, aux déploiements et même aux microservices individuels. Chaque équipe visualise ainsi le coût mensuel de ses services. Ce showback est le point où le FinOps transforme une donnée en changement de comportement.
La régularité est essentielle. Un rapport de coûts que personne ne consulte ne modifie rien. Un suivi mensuel concis par équipe, axé sur l’évolution de ses propres coûts, crée l’incitation nécessaire pour que chacun nettoie lui-même les requêtes inefficaces et les environnements de test oubliés.
Un workflow mensuel de Rightsizing
L’optimisation des coûts est une routine permanente. Un cycle mensuel léger suffit : analyser les données d’utilisation des dernières semaines, identifier les plus grandes divergences entre les requêtes et la charge réelle, ajuster les valeurs pour les principaux candidats, puis vérifier lors du cycle suivant si l’ajustement a été maintenu.
L’attrait de cette méthode réside dans sa répétabilité. Une fois le cycle instauré, le taux d’utilisation reste durablement élevé, sans avoir à nettoyer une fois pour toutes avant de voir les requêtes repartir à la hausse. Des coûts Cloud prévisibles naissent d’une habitude que l’on installe une fois pour toutes.
Foire aux questions
Quelle est la différence entre Requests et Limits ?
Les Requests correspondent à la capacité garantie réservée par un Pod et facturée. Les Limits définissent le plafond maximal qu’il peut consommer. Des Requests trop élevées réservent une capacité coûteuse sans l’utiliser, tandis que des valeurs trop basses risquent d’entraîner une éviction. Le Rightsizing permet de trouver l’équilibre entre les deux.
Le Vertical Pod Autoscaler est-il prêt pour la production ?
Pour les recommandations, oui. En mode automatique, il faut l’utiliser avec prudence. De nombreuses équipes exploitent le VPA en mode recommandation, vérifient les propositions et les appliquent de manière contrôlée. Cela permet de conserver la maîtrise des workloads critiques au sein de l’équipe.
Ai-je besoin de Kubecost ou le billing du Cloud suffit-il ?
Le billing du Cloud s’arrête à la frontière des nœuds et n’affiche pas les coûts par microservice. Des outils comme Kubecost décomposent les coûts des clusters jusqu’au niveau des namespaces et des déploiements. Pour un véritable showback au sein des équipes, il est difficile de s’en passer.
L’autoscaling réduit-il vraiment les coûts ou seulement la charge ?
Les deux sont liés. Le Horizontal Pod Autoscaler et le Cluster Autoscaler réduisent activement la capacité provisionnée en période de faible charge. Moins de nœuds en fonctionnement signifie directement une facture moins élevée, à condition que le Rightsizing des Pods soit bien réalisé.
À partir de quelle taille de cluster le FinOps avec Kubernetes devient-il rentable ?
L’effort se justifie dès quelques clusters de production, dès que la facture mensuelle devient significative. Le Rightsizing et les quotas de ressources s’intègrent avec un effort raisonnable et agissent immédiatement sur la capacité réservée.
Sélection de la rédaction
cloudmagazinFinOps : réduire de 30 % les coûts du cloud, un objectif réaliste ?cloudmagazinLe processeur cloud bon marché qui vous enferme dans un piège coûteuxcloudmagazinHyperscaler allemand : qui possède vraiment les atouts ?Plus du réseau MBF Media
MyBusinessFutureIA bon marché venue de Chine : les points à vérifier pour les achatsDigital ChiefsWashington décide quels modèles d’IA sont autorisés à fonctionner iciSecurityTodayCodex Security : un client open source alimente OpenAISource de l’image : générée par IA (mai 2026)
Traduit de l’original allemand par intelligence artificielle. La version allemande fait foi.


