Arquitectura cross-cloud Lakehouse y caché de salida: cómo Google Cloud Next 2026 impacta a los arquitectos DACH
Google Cloud Next 2026 convierte la interoperabilidad entre nubes en una cuestión de costos: cómo la arquitectura Lakehouse y el almacenamiento en caché…
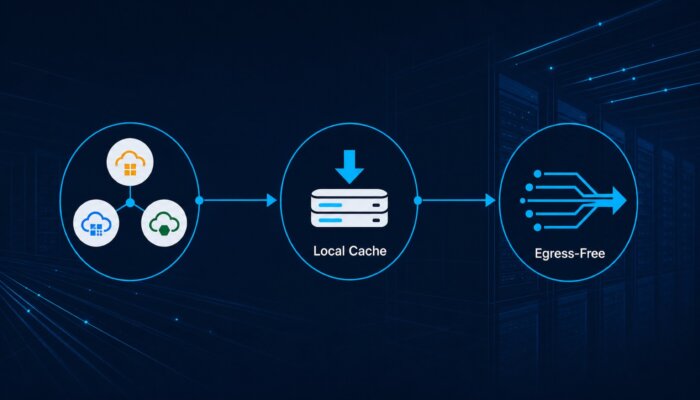
Google ha anunciado en la Cloud Next 2026 componentes que convierten el multi-cloud de la teoría arquitectónica en una decisión operativa. Quien como CIO del DACH aún cree que una estrategia de cross-cloud fracasa por los costes de egress y los silos de datos, debería mirar bien de cerca: hoy la palanca está en dónde se encuentran los datos y en lo que cuesta moverlos.
Lo más importante en breve
- Cross-cloud Lakehouse (antes BigLake) permite ahora consultas sobre fuentes de datos de AWS, Azure y GCP sin replicación completa, la capa de cross-cloud caching deposita la primera lectura en el sistema de origen y limita las tasas de egress a las consultas recurrentes.
- Gemini Enterprise Agent Platform agrupa registros de agentes, registros de skills y gobernanza en una capa concebida explícitamente para despliegues multi-cloud que actúa como plano de control sobre las cargas de trabajo existentes.
- Agentic Data Cloud convierte el almacenamiento de datos en una cuestión estratégica: quien controla las tablas maestras controla el stack de agentes que las utiliza.
- AWS y Google han anunciado por separado una cooperación de despliegue multi-cloud, lo que hace que las cargas de trabajo sean técnicamente más portables entre los hyperscalers y a la vez intensifica la carrera por la capa de datos.
- Consecuencia operativa para los CIO: la pregunta gira ahora en torno a „dónde queda el maestro de datos, dónde se permite calcular y quién asume el riesgo del caché“.
El egress como impuesto oculto sobre cada idea multi-cloud
Quien en los últimos tres años ha intentado seriamente distribuir cargas de trabajo entre dos hyperscalers conoce el reflejo del lado del CFO: los costes de egress. AWS, Azure y GCP cobran por cada gigabyte de tráfico saliente importes que, sumados en un pipeline de 80 terabytes al mes, alcanzan rápidamente cifras de cinco dígitos. Estas tarifas responden a un cálculo deliberado: así se ve el vendor lock-in convertido en una partida del balance. Los datos que una vez descansan en un bucket vuelven a salir caros.
La función de cross-cloud caching que Google presentó en la Next 2026 actúa precisamente aquí. Almacena localmente en la caché del lakehouse los datos que una vez cruzaron la frontera de la nube, de modo que las consultas recurrentes dejan de disparar egress en cada ocasión. Para un entorno de reporting que consume a diario el mismo conjunto de datos de un bucket de S3, eso significa en el mejor de los casos un orden de magnitud menos de tráfico saliente. La verdad arquitectónica que hay detrás: el caching es una técnica de sobra consolidada, pero cuando un hyperscaler lo ofrece como servicio nativo a través de las fronteras de nubes ajenas, el cálculo del ROI para el cross-cloud se desplaza de forma masiva.
Un ejemplo del DACH hace tangible la magnitud
Un grupo industrial de tamaño medio que recoge los datos de sus máquinas en AWS S3 y los analiza con GCP BigQuery registra, según sus propias cifras, unos 12 TB de egress cross-cloud al mes. Con las tarifas actuales de AWS, eso supone casi 1.080 euros al mes, solo por el movimiento de datos. Con una cache hit rate del 70 por ciento en las consultas recurrentes de analítica, el tráfico saliente baja a unos 3,6 TB y la factura a unos 330 euros. A lo largo del año, la diferencia asciende a 9.000 euros en un único camino de datos. Quien opera varios pipelines de este tipo habla pronto de efectos de seis dígitos.
Del silo de datos al lakehouse borderless
El segundo desplazamiento procede del propio lakehouse. Google llama „borderless“ a la nueva variante: la capa del lakehouse puede referenciar tablas que residen físicamente en S3 o en Azure Data Lake, sin que haya que replicar los datos dentro de BigQuery. Para los equipos de ingeniería eso significa: menos ETL, menos sync jobs y menos puntos en los que un schema drift rompe el informe. Para los CIO significa: la pregunta de dónde „pertenecen“ los datos puede responderse de nuevo a nivel político y contractual, sin que cada respuesta desencadene de inmediato un proyecto de migración.
La otra cara: quien controla la capa del lakehouse controla la lógica de consulta. Google se posiciona aquí como intermediario neutral, algo estratégicamente inteligente: el compute propio se convierte en la engine de consulta estándar sobre buckets ajenos. AWS y Azure tienen iniciativas comparables, aunque cada una está más anclada en su propio ecosistema. La elección de qué capa de lakehouse se convertirá en el estándar de facto en una enterprise del DACH es, con ello, una decisión estratégica de vendor con una larga vigencia.
„Hasta ahora el multi-cloud era una respuesta de compliance. Con las nuevas capas de lakehouse y de caching se convierte en una opción arquitectónica, pero la elección de quién lidera la capa de datos sigue siendo una decisión de lock-in a largo plazo.“
Stack de agentes: quien controla los datos controla las skills
La Gemini Enterprise Agent Platform y la Agentic Data Cloud son el anuncio de mayor calado estratégico. Google agrupa agent registry, skill registry, tool registry y gobernanza en una capa concebida explícitamente para gobernar conjuntamente las cargas de trabajo de AWS, Azure y GCP. Con ello, Google orienta su propuesta hacia el mensaje „seremos el plano de control sobre vuestras apps existentes“, dejando atrás el clásico „migrad vuestras apps a nosotros“. Desde la óptica del CIO resulta atractivo porque cambia la relación de inversión: el gasto se desplaza del proyecto de migración de workloads hacia una suscripción abstracta de control.
Eso sí, el riesgo solo se desplaza una capa hacia arriba. Quien dentro de dos años compruebe que el agent registry y el tool inventory están en Google experimentará con el „cambiamos de plano de control“ el mismo efecto de lock-in que el multi-cloud pretendía evitar. La única respuesta sostenible: imponer estándares abiertos para definiciones de agentes, esquemas de skills y manifiestos de tools antes de que los formatos propietarios creen hechos consumados.
El compliance aterriza en la capa cross-cloud
Lo que a menudo se pierde en el debate arquitectónico: el RGPD, NIS2 y el EU AI Act prescriben dónde se procesan los datos y quién puede verlos, mientras que la elección del proveedor de nube queda en manos de cada empresa. Una capa de cross-cloud caching que conserva datos personales en una caché de GCP, aunque la tabla maestra resida en un centro de datos de AWS en Alemania, no es trivial desde la óptica de la protección de datos. La pregunta operativa es: qué categoría de datos se puede cachear y dónde. Y cómo se documenta el ciclo de vida de la caché cuando el regulador pregunta.
La respuesta del vendor será el „policy-driven caching“, es decir, reglas que definen qué clases de datos pueden cruzar qué fronteras de nube. En la práctica eso significa: antes del primer montaje productivo de un pipeline cross-cloud debe existir un esquema de clasificación de datos. Quien lo posponga se construye un generador de hallazgos de auditoría.
Tres preguntas de control antes del siguiente paso multi-cloud
1. ¿Dónde están los datos maestros y dónde se permite que estén sus copias? El caching suena a cuestión de performance, pero es una cuestión de compliance. La clasificación de datos es el requisito previo de cualquier cross-cloud caching.
2. ¿Qué engine de consulta se convertirá en el estándar? Las capas de lakehouse tienen periodos de vigencia de cinco a diez años. La elección de si BigQuery, Athena, Synapse o Snowflake se convertirá en la ruta de consulta dominante es una decisión estratégica de vendor que va más allá del tooling.
3. ¿Quién controla el plano de control de los agentes? Si el agent registry y el tool inventory están en un hyperscaler, el multi-cloud está en buen estado a nivel de compute, pero a nivel de inteligencia vuelve a estar centralizado. Las conversaciones sobre estándares abiertos deben empezar ahora, antes de que transcurran dos años.
Preguntas frecuentes
¿Cuánto cuesta en concreto el cross-cloud caching?
Google no anunció precios de lista separados en la presentación. La lógica económica reside en la reducción de las tasas de egress existentes, y el caché en sí se factura dentro de la capa de compute, mediante reservas de slots de BigQuery o pricing on-demand.
¿Funciona esto solo con Google en el centro?
Por ahora sí: la implementación del cross-cloud lakehouse presupone que BigQuery es la engine de consulta. AWS y Azure tienen enfoques comparables (Athena Federated Queries, Synapse Link) que ponen respectivamente su engine de origen en el centro. La neutralidad real entre proveedores solo llega vía estándares abiertos como Apache Iceberg, que los tres hyperscalers ya admiten.
¿Es relevante para el Mittelstand del DACH o es un tema exclusivo de grandes grupos?
Se vuelve relevante en el momento en que una empresa opera dos cuentas de nube productivas en paralelo, algo más frecuente de lo esperado en el Mittelstand del DACH, a menudo por adquisiciones o por proveedores SaaS con backends de nube cableados de forma fija. Quien paga más de 500 euros de egress al mes debería calcular el ROI.
¿Qué debería estar aclarado antes del primer proyecto de pipeline cross-cloud?
Tres cosas: un esquema de clasificación de datos con permisos de caché claros por categoría, una decisión sobre qué engine de consulta se convertirá en el lenguaje estándar y una ruta de escalada documentada para los hallazgos de auditoría en torno al contenido de la caché. Sin estos tres puntos, la primera carta del regulador será dolorosa.
¿En qué se diferencia el egress caching de un CDN clásico?
Un CDN acelera los contenidos entregados en el borde de la red. El egress caching actúa antes: mantiene los conjuntos de datos consultados con frecuencia cerca de la región de compute, para que las consultas cross-cloud repetidas no disparen cada vez costosas tasas de egress. La ganancia está en la curva de costes.
Fuente de la imagen: generada por IA (junio de 2026), certificado C2PA incrustado en la imagen
Traducido del original en alemán con inteligencia artificial. La versión alemana es la de referencia.
Más de la red MBF Media
- MyBusinessFuture: La visión estratégica de la gobernanza de IA en el Mittelstand
- SecurityToday: Lo que el desplazamiento de workloads en la nube significa para los CISO
- Digital Chiefs: El vendor lock-in como tema del consejo en 2026


