Cross-cloud Lakehouse et cache de sortie : ce que Google Cloud Next 2026 change pour les
Google Cloud Next 2026 rend le cross-cloud une question de coût : comment l'architecture Lakehouse et le cache de sortie brisent le verrouillage du…
Google a annoncé lors de la Cloud Next 2026 des briques qui font passer le multi-cloud de la théorie architecturale à la décision opérationnelle. Tout DACH-CIO qui croit encore qu’une stratégie cross-cloud échoue à cause des coûts d’egress et des silos de données devrait y regarder de très près : le levier se situe aujourd’hui dans l’endroit où résident les données et dans le coût de leur déplacement.
L’essentiel en bref
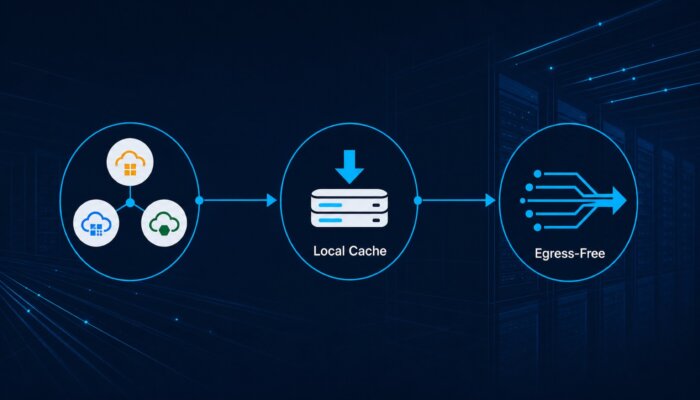
- Cross-cloud Lakehouse (anciennement BigLake) permet désormais de requêter des sources de données AWS, Azure et GCP sans réplication complète, la couche de caching cross-cloud place la première lecture dans le système d’origine et fait retomber les frais d’egress sur les requêtes récurrentes.
- Gemini Enterprise Agent Platform regroupe registries d’agents, registries de skills et gouvernance dans une couche conçue explicitement pour les déploiements multi-cloud et qui sert de control plane au-dessus des workloads existants.
- Agentic Data Cloud fait de la détention des données une question stratégique : qui contrôle les tables maîtres contrôle le stack d’agents qui les exploite.
- AWS et Google ont annoncé séparément une coopération de déploiement multi-cloud, ce qui rend les workloads techniquement plus faciles à porter d’un hyperscaler à l’autre, tout en durcissant encore la course à la couche de données.
- Conséquence opérationnelle pour les CIO : la question « dans quel cloud » laisse désormais la place à « où restent les données maîtres, où a-t-on le droit de calculer, qui porte le risque du cache ».
L’egress, une taxe cachée sur chaque idée multi-cloud
Qui a sérieusement tenté ces trois dernières années de répartir ses workloads sur deux hyperscalers connaît le réflexe du camp des CFO : les coûts d’egress. AWS, Azure et GCP facturent chaque gigaoctet de trafic sortant à des tarifs qui, cumulés sur un pipeline de 80 téraoctets par mois, atteignent vite cinq chiffres. Ces tarifs sont parfaitement délibérés : voilà à quoi ressemble le vendor lock-in une fois traduit en poste de bilan. Les données installées dans un bucket ressortent ensuite à un prix élevé.
La fonction de caching cross-cloud que Google a présentée à la Next 2026 agit précisément à ce niveau. Elle conserve localement dans le cache du lakehouse les données déjà passées de l’autre côté de la frontière du cloud, si bien que les requêtes récurrentes ne déclenchent plus d’egress à chaque exécution. Pour un dispositif de reporting qui consomme chaque jour le même jeu de données depuis un bucket S3, cela représente, dans le meilleur des cas, un ordre de grandeur de trafic sortant en moins. La vérité architecturale derrière tout cela : le caching est une technique éprouvée, et dès qu’un hyperscaler l’offre en service natif par-dessus les frontières d’un cloud tiers, le calcul de ROI du cross-cloud bascule massivement.
Un exemple DACH rend l’ordre de grandeur tangible
Un groupe industriel de taille intermédiaire qui collecte ses données machines dans AWS S3 et les analyse via GCP BigQuery génère de son propre aveu environ 12 TB d’egress cross-cloud par mois. Aux tarifs AWS actuels, cela représente près de 1 080 euros par mois, uniquement pour le déplacement des données. Avec un taux de hits du cache de 70 % sur les requêtes analytics récurrentes, le trafic sortant retombe à environ 3,6 TB et la facture à environ 330 euros. Sur l’année, l’écart atteint 9 000 euros, pour un seul chemin de données. Qui exploite plusieurs pipelines de ce type parle vite d’effets à six chiffres.
Du silo de données au lakehouse borderless
La deuxième bascule vient du lakehouse lui-même. Google baptise la nouvelle variante « borderless » : la couche lakehouse peut référencer des tables stockées physiquement dans S3 ou Azure Data Lake, sans que les données aient besoin d’être répliquées dans BigQuery. Pour les équipes d’ingénierie, cela signifie moins d’ETL, moins de jobs de synchronisation, moins d’endroits où une dérive de schéma vient casser le reporting. Pour les CIO, cela signifie que la question de l’endroit où les données « doivent se trouver » peut recevoir une nouvelle réponse, politique et contractuelle, sans que chaque réponse déclenche aussitôt un projet de migration.
L’envers de la décors : qui contrôle la couche lakehouse contrôle la logique de requêtage. Google se positionne ici en intermédiaire neutre, un choix stratégiquement habile : son propre compute devient le moteur de requêtage standard au-dessus des buckets d’autrui. AWS et Azure mènent des initiatives comparables, chacune toutefois plus fortement ancrée dans son propre écosystème. Le choix de la couche lakehouse qui s’imposera comme standard de facto dans une entreprise du DACH constitue dès lors une décision de stratégie vendor à longue portée.
« Le multi-cloud était jusqu’ici une réponse de conformité. Avec les nouvelles couches de lakehouse et de caching, il devient une option architecturale, mais le choix de celui qui pilote la couche de données demeure une décision de lock-in à long terme. »
Stack d’agents : qui contrôle les données contrôle les skills
La Gemini Enterprise Agent Platform et l’Agentic Data Cloud constituent l’annonce aux implications les plus stratégiques. Google regroupe agent registry, skill registry, tool registry et gouvernance dans une couche explicitement conçue pour piloter ensemble les workloads AWS, Azure et GCP. Google mise ainsi sur la formule « nous devenons le control plane au-dessus de vos applications existantes » ; l’époque du discours « migrez vos applications chez nous » est révolue. Du point de vue d’un CIO, c’est attractif, car le rapport à l’investissement s’en trouve changé : le budget finance un abonnement de pilotage abstrait qui remplace le projet classique de migration de workloads.
Le risque est toutefois seulement déplacé d’une couche vers le haut. Qui constatera dans deux ans que l’agent registry et l’inventaire des tools résident chez Google vivra, avec le réflexe « nous changeons simplement de control plane », exactement le même effet de lock-in que le multi-cloud était censé éviter. La seule réponse durable : imposer des standards ouverts pour les définitions d’agents, les schémas de skills et les manifestes de tools, avant que les formats propriétaires n’aient créé de situations de fait.
La conformité atterrit sur la couche cross-cloud
Ce que le débat architectural oublie souvent : le RGPD, NIS2 et l’EU AI Act laissent toute latitude sur le choix du cloud provider ; ils encadrent en revanche le lieu où les données sont traitées et les personnes autorisées à y accéder. Une couche de caching cross-cloud qui conserve des données personnelles dans un cache GCP alors que la table maître se trouve dans un centre de données AWS en Allemagne soulève de vraies questions de droit à la protection des données. La question opérationnelle : quelle catégorie de données a le droit d’être mise en cache, et où ? Et comment le cycle de vie du cache est-il documenté lorsque l’autorité de contrôle pose des questions ?
La réponse des vendors s’appellera « policy-driven caching », autrement dit des règles qui déterminent quelles classes de données sont autorisées à franchir quelles frontières de cloud. En pratique, cela signifie : un schéma de classification des données doit être en place avant la construction du premier pipeline cross-cloud en production. Qui repousse cela à plus tard se fabrique un générateur de constats d’audit.
Trois questions de contrôle avant le prochain pas multi-cloud
1. Où se trouvent les données maîtres et où est-il permis d’en stocker des copies ? Le caching a des allures de question de performance, il relève en réalité de la conformité. Toute mise en cache cross-cloud exige au préalable une classification des données.
2. Quel moteur de requêtage deviendra le standard ? Les couches lakehouse affichent des demi-vies de cinq à dix ans. Le choix du chemin de requêtage dominant, BigQuery, Athena, Synapse ou Snowflake, relève d’une décision de stratégie vendor avant d’être une affaire de tooling.
3. Qui contrôle le control plane des agents ? Lorsque l’agent registry et l’inventaire des tools résident chez un hyperscaler, le multi-cloud reste solide au niveau du compute et se recentre à nouveau au niveau de l’intelligence. Les discussions sur les standards ouverts doivent être engagées dès aujourd’hui.
Questions fréquentes
Combien coûte concrètement le caching cross-cloud ?
Lors de la présentation, Google n’a communiqué aucun tarif catalogue distinct. La logique économique repose sur la réduction des frais d’egress existants ; le cache lui-même se facture via des réservations de slots BigQuery ou via le on-demand pricing, donc au niveau de la couche compute, sans tarif de caching séparé.
Fonctionne-t-il uniquement avec Google en position centrale ?
Pour l’instant, oui : l’implémentation du lakehouse cross-cloud suppose que BigQuery serve de moteur de requêtage. AWS et Azure proposent des approches comparables (Athena Federated Queries, Synapse Link), chacune centrée sur son moteur d’origine. Une véritable neutralité entre fournisseurs passe uniquement par des standards ouverts comme Apache Iceberg, que les trois hyperscalers prennent désormais en charge.
Est-ce pertinent pour le Mittelstand du DACH ou réservé aux grands groupes ?
La question devient concrète dès qu’une entreprise exploite en parallèle deux comptes cloud en production ; c’est plus fréquent qu’on ne le pense dans le Mittelstand du DACH, souvent à la suite d’acquisitions ou via des fournisseurs SaaS aux backends cloud étroitement liés. Qui paie chaque mois plus de 500 euros d’egress gagne à calculer le ROI.
Que doit-on clarifier avant le premier projet de pipeline cross-cloud ?
Trois choses : un schéma de classification des données avec des autorisations de cache claires par catégorie, une décision sur le moteur de requêtage qui deviendra le langage standard et un chemin d’escalade documenté pour les constats d’audit relatifs aux contenus du cache. Sans ces trois points, le premier courrier de l’autorité se révélera douloureux.
En quoi le caching d’egress se distingue-t-il d’un CDN classique ?
Un CDN accélère, en bordure du réseau, la livraison des contenus. Le caching d’egress intervient plus en amont : il conserve les jeux de données fréquemment interrogés à proximité de la région de compute, afin que les requêtes cross-cloud répétées ne déclenchent plus à chaque appel de coûteux frais d’egress. Le gain se joue dans la courbe des coûts.
Source de l’image : générée par IA (juin 2026), certificat C2PA intégré dans l’image
Traduit de l’original allemand par intelligence artificielle. La version allemande fait foi.
Plus de contenus du réseau MBF Media
- MyBusinessFuture : Le regard stratégique sur la gouvernance de l’IA dans le Mittelstand
- SecurityToday : Ce que le déplacement des workloads cloud implique pour les CISO
- Digital Chiefs : Le vendor lock-in comme sujet de conseil d’administration en 2026


