Ghost Core lleva al agente de IA al salón
Ghost Core ejecuta agentes de IA locales sin interrupción. La primera remesa está agotada según su fundador; los PC RTX Spark llegarían en otoño.
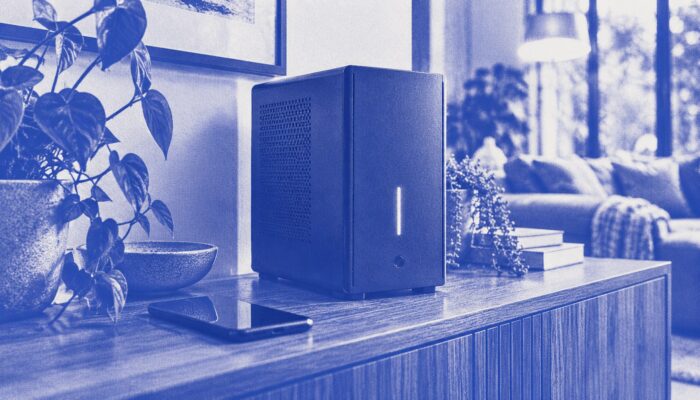
La start-up Ghost vende Core, un equipo que ejecuta continuamente en el dispositivo modelos de IA abiertos y agentes locales con acceso al correo y al calendario. Según su fundador, la primera remesa, a unos 3.120 euros netos, está agotada y se entregaría a finales de octubre. En otoño se esperan PC con NVIDIA RTX Spark.
Lo más importante en resumen
- Ghost Core ejecuta continuamente modelos de IA abiertos y un agente personal en el dispositivo. Según su fundador, la primera remesa, a unos 3.120 euros netos, está agotada y se entregaría a finales de octubre.
- La promesa sobre los datos se aplica al modelo de IA y a su memoria. Core sigue necesitando conexión a Internet para búsquedas web, correo electrónico y actualizaciones de software.
- Según Gartner, los modelos pequeños y especializados por tarea se utilizarían tres veces más que los grandes modelos de lenguaje de aquí a 2027. Además de Ghost, ASUS, Dell, HP, Lenovo, Microsoft Surface y MSI prevén lanzar en otoño dispositivos con NVIDIA RTX Spark.
Relacionado:Descargable no significa operable / DGX Spark vs. Mac Mini: El prellenado cuenta
El ordenador personal de IA
Zain Javaid tiene 19 años, trabajó antes como operador cuantitativo y ha conseguido para su start-up Ghost una financiación semilla, es decir, una ronda de financiación temprana, de unos 9,8 millones de euros. Andreessen Horowitz lidera la ronda, en la que también participan Abstract, Audacious Ventures, SV Angel y Nova. El producto se llama Core. Ghost lo presenta como un ordenador personal de IA que ejecuta modelos locales íntegramente en el dispositivo las 24 horas del día.
Core se controla desde un portátil, una aplicación móvil o iMessage. El dispositivo se conecta al correo, al calendario, a los archivos, a los equipos del hogar inteligente y al historial del navegador, así como a dispositivos ponibles como Oura, Eight Sleep y Whoop. Core dispone de su propio sistema de archivos, un navegador y herramientas para actuar por sí mismo. En la demostración, el agente busca en la web empresas de mudanzas en San Francisco, las llama y compara los precios.
Javaid justifica el hardware propio porque, aunque los modelos pueden ejecutarse en los ordenadores existentes, la experiencia resulta mala en muchos aspectos. La primera remesa cuesta unos 3.120 euros netos, se monta en San Francisco y, según él, ya está agotada. La entrega está prevista para el 31 de octubre.
¿Qué es la inferencia local? La inferencia consiste en ejecutar un modelo de IA entrenado que genera una respuesta a partir de una entrada. En la inferencia local, el modelo realiza el cálculo en el dispositivo del usuario, por ejemplo mediante su tarjeta gráfica y su memoria RAM. En Ghost Core, esto se aplica al modelo de IA y a su memoria; el equipo sigue necesitando conexión a Internet para las búsquedas web, el correo y las actualizaciones de software.
Qué hay dentro de la carcasa
El componente central es una NVIDIA RTX PRO 4000 Blackwell en formato compacto SFF, con 24 GB de memoria gráfica GDDR7 ECC y un ancho de banda de memoria de 432 GB/s. La tarjeta está diseñada para 70 vatios. Se añaden un AMD Ryzen 5 7600 con 6 núcleos y 12 hilos, 64 GB de RAM DDR5 y un SSD NVMe de 1 TB. Ghost indica 770 AI TOPS, una medida de la potencia de cálculo para IA.
Los modelos abiertos Qwen 3.8-Next, Qwen 3.8-27B, Gemma 4-31B y Muse-Glimmer-30B vienen preinstalados. Según Javaid, los modelos de hasta unos 30.000 millones de parámetros, es decir, valores ajustables del modelo, se ejecutan íntegramente en la tarjeta gráfica. Los mayores, como Qwen-3.8-Next, trasladan una parte a la RAM.
Para la velocidad, Ghost indica más de 87 tokens por segundo con Qwen-3.8-27B y 32 con Qwen-3.8-Next. Los tokens son los fragmentos de palabras con los que los modelos de lenguaje generan texto. Estos valores no se han medido de forma independiente. Ante las críticas, Javaid habló de entre 70 y más de 80 tokens por segundo para el modelo 27B. Lo atribuye a optimizaciones de las rutinas de cálculo a nivel del kernel y a la predicción de varios tokens, o Multi-Token-Prediction. Este método permite al modelo predecir varios tokens en cada paso. El software de código abierto llama.cpp acaba de incorporar también esta técnica y anuncia en una NVIDIA DGX Spark una aceleración de aproximadamente 1,5 veces en la decodificación. Para Vitalik Buterin, cofundador de Ethereum, entre 20 y 30 tokens por segundo resultan demasiado lentos; solo percibe fluidez a partir de 100.
Dónde termina la promesa sobre los datos
Ghost promete que ningún dato sale de casa. Según el fabricante, Core cifra, almacena y procesa los datos íntegramente en el dispositivo. El código fuente, la lógica y los pesos de los modelos también se encuentran en local para que Core no dependa de un operador de servicios externo. Los nuevos modelos llegan mediante actualizaciones inalámbricas, como en Tesla.
Sin embargo, Core necesita conexión a Internet para las búsquedas web, el correo y estas actualizaciones de software. Por tanto, la promesa se aplica al modelo de IA y a su memoria. Las búsquedas, el correo y las actualizaciones siguen pasando por la red; el agente de la demostración también encuentra las empresas de mudanzas en la web.
Javaid reconoce una diferencia en la calidad de los modelos. Los pequeños y medianos aún no están al nivel de los mejores, pero, según él, bastan para la mayoría de las tareas cotidianas. En una o dos generaciones de modelos, espera que ya no exista una diferencia significativa entre el modelo Opus actual y lo que se ejecuta en Core. Buterin describe una estrategia en la que un modelo local actúa como centro de control y recurre a modelos cloud potentes como herramientas para tareas más exigentes.
NVIDIA y Microsoft amplían el mercado
NVIDIA ha desarrollado RTX Spark para PC Windows en la era de los agentes personales de IA. La plataforma combina una GPU Blackwell RTX con 6.144 núcleos CUDA y una CPU Grace con 20 núcleos, ofrece hasta 1 petaflop de potencia de cálculo para IA y dispone de 128 GB de memoria compartida. ASUS, Dell, HP, Lenovo, Microsoft Surface y MSI prevén lanzar portátiles y equipos de sobremesa en otoño; Acer y Gigabyte les seguirán. NVIDIA y Microsoft construyen conjuntamente una plataforma Windows segura para agentes en el dispositivo, con nuevas funciones de seguridad en el sistema operativo y NVIDIA OpenShell.
El 7 de octubre, Satya Nadella, CEO de Microsoft, Pavan Davuluri, responsable de Windows, y Jensen Huang, CEO de NVIDIA, prevén aparecer juntos en San Francisco. Presentarán novedades de Windows, RTX Spark, Surface y el ecosistema PC. La entrega de Ghost Core está prevista para el 31 de octubre, mientras que NVIDIA anuncia los primeros portátiles y equipos de sobremesa RTX Spark para otoño de 2026.
La perspectiva de la TI empresarial
Según Gartner, de aquí a 2027 las organizaciones utilizarán los modelos de IA pequeños y especializados por tarea tres veces más que los grandes modelos de lenguaje de propósito general. El analista de Gartner Sumit Agarwal cita como motivos los menores costes de cálculo y de operación, así como una mayor precisión en tareas especializadas.
Tom Mainelli, Group Vice President de Device & Consumer Research en IDC, ve un obstáculo en los dispositivos de empresa. Los equipos de TI habrían dejado claro que no permitirán software autónomo en dispositivos gestionados sin el control correspondiente. Mainelli considera abierta la cuestión de si los grandes laboratorios de IA concluirán que una parte de su inferencia debe ejecutarse en el escritorio del cliente.
Preguntas frecuentes
¿Hay costes recurrentes después de comprar Ghost Core?
Según el fabricante, Core no necesita suscripción. El equipo incluye 1 año de garantía y un derecho de devolución de 30 días.
¿Pueden otros programas utilizar los modelos de Core?
Core ofrece una interfaz compatible con la OpenAI Responses API. Otras aplicaciones, scripts y agentes pueden acceder a los modelos locales a través de ella sin tarifas por token.
¿Por qué Core es más barato que una NVIDIA DGX Spark?
Javaid lo explica por las compras. Ghost habría asegurado tarjetas gráficas a precios anteriores a las subidas y trasladaría el ahorro a los clientes.
Selección editorial
cloudmagazinKolibri: modelo de IA alemán para el propio centro de datoscloudmagazinAlquiler de GPU sin hyperscalers: qué ofrecen las Neo CloudscloudmagazinGoogle Gemini en la empresa: lo que exige la Ley de Inteligencia ArtificialMás de la red MBF Media
MyBusinessFutureIA en productos médicos: Las nuevas obligaciones de la UEFuente de la imagen: generada por IA (octubre de 2026)
Traducido del original en alemán con inteligencia artificial. La versión alemana es la de referencia.


