Ghost Core fait entrer l’agent IA dans le salon
Ghost Core exécute des agents IA locaux en continu. La première série est épuisée selon son fondateur ; les PC RTX Spark sont prévus à l’automne.
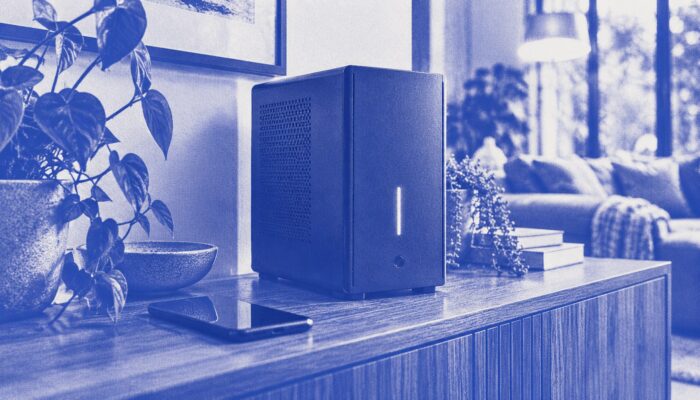
La start-up Ghost vend Core, un ordinateur qui exécute en continu, sur l’appareil, des modèles d’IA ouverts et des agents locaux reliés aux mails et au calendrier. Selon son fondateur, la première série, à environ 3 120 euros HT, est épuisée et doit être livrée fin octobre. Des PC NVIDIA RTX Spark sont prévus à l’automne.
L’essentiel en bref
- Ghost Core exécute en continu des modèles d’IA ouverts et un agent personnel sur l’appareil. Selon son fondateur, la première série, à environ 3 120 euros HT, est épuisée et doit être livrée fin octobre.
- La promesse sur les données concerne le modèle d’IA et sa mémoire. Core a toujours besoin d’une connexion Internet pour les recherches web, les e-mails et les mises à jour logicielles.
- Selon Gartner, les petits modèles spécialisés par tâche devraient être utilisés trois fois plus souvent que les grands modèles de langage d’ici 2027. Outre Ghost, ASUS, Dell, HP, Lenovo, Microsoft Surface et MSI devraient proposer à l’automne des appareils équipés de NVIDIA RTX Spark.
À lire aussi :Téléchargeable ne signifie pas exploitable / DGX Spark contre Mac Mini : le préremplissage compte
L’ordinateur d’IA personnel
Zain Javaid a 19 ans, a auparavant travaillé comme trader quantitatif et a levé environ 9,8 millions d’euros en amorçage, c’est-à-dire lors d’un premier tour de financement, pour sa start-up Ghost. Andreessen Horowitz mène le tour de table, auquel participent aussi Abstract, Audacious Ventures, SV Angel et Nova. Le produit s’appelle Core. Ghost le présente comme un ordinateur d’IA personnel qui exécute des modèles locaux entièrement sur l’appareil, 24 heures sur 24.
Core se commande depuis un ordinateur portable, une application mobile ou iMessage. L’appareil se connecte aux mails, au calendrier, aux fichiers, aux équipements domotiques et à l’historique du navigateur, ainsi qu’à des objets connectés portés sur soi tels qu’Oura, Eight Sleep et Whoop. Core possède son propre système de fichiers, un navigateur et des outils pour agir lui-même. Dans la démonstration, l’agent cherche sur le web des entreprises de déménagement à San Francisco, les appelle et compare les prix.
Javaid justifie le matériel dédié en expliquant que, si les modèles peuvent fonctionner sur les ordinateurs existants, l’expérience est mauvaise à bien des égards. La première série coûte environ 3 120 euros HT, est assemblée à San Francisco et serait déjà, selon lui, épuisée. Les livraisons sont prévues pour le 31 octobre.
Qu’est-ce que l’inférence locale ? L’inférence consiste à exécuter un modèle d’IA entraîné pour produire une réponse à partir d’une entrée. Lors d’une inférence locale, le modèle calcule sur l’appareil de l’utilisateur, par exemple avec sa carte graphique et sa mémoire vive. Pour Ghost Core, cela concerne le modèle d’IA et sa mémoire ; l’appareil a toujours besoin d’une connexion Internet pour les recherches web, les e-mails et les mises à jour logicielles.
Ce que contient le boîtier
Au cœur de l’appareil se trouve une NVIDIA RTX PRO 4000 Blackwell au format compact SFF, avec 24 Go de mémoire graphique GDDR7 ECC et une bande passante mémoire de 432 Go/s. La carte est prévue pour 70 watts. S’y ajoutent un AMD Ryzen 5 7600 à 6 cœurs et 12 threads, 64 Go de mémoire vive DDR5 et un SSD NVMe de 1 To. Ghost annonce 770 AI TOPS, un indicateur de puissance de calcul pour l’IA.
Les modèles ouverts Qwen 3.8-Next, Qwen 3.8-27B, Gemma 4-31B et Muse-Glimmer-30B sont préinstallés. Selon Javaid, les modèles comptant jusqu’à environ 30 milliards de paramètres, c’est-à-dire les valeurs ajustables du modèle, fonctionnent entièrement sur la carte graphique. Les plus grands, comme Qwen-3.8-Next, transfèrent une partie en mémoire vive.
Pour la vitesse, Ghost annonce plus de 87 tokens par seconde avec Qwen-3.8-27B et 32 avec Qwen-3.8-Next. Les tokens sont les fragments de mots avec lesquels les modèles de langage génèrent du texte. Ces valeurs n’ont pas été mesurées indépendamment. En réponse aux critiques, Javaid a évoqué 70 à plus de 80 tokens par seconde pour le modèle 27B. Il attribue ces performances à l’optimisation des routines de calcul au niveau du kernel et à la prédiction de plusieurs tokens, ou Multi-Token-Prediction. Ce procédé permet au modèle de prédire plusieurs tokens à chaque étape. Le logiciel open source llama.cpp vient lui aussi d’intégrer cette technique et annonce une accélération d’environ 1,5 fois du décodage sur une NVIDIA DGX Spark. Pour Vitalik Buterin, cofondateur d’Ethereum, 20 à 30 tokens par seconde sont trop lents ; l’expérience ne lui paraît fluide qu’à partir de 100.
Où s’arrête la promesse sur les données
Ghost promet qu’aucune donnée ne quitte le domicile. Selon le fabricant, Core chiffre, stocke et traite les données entièrement sur l’appareil. Le code source, la logique et les poids des modèles se trouvent aussi en local, afin que Core ne dépende pas d’un opérateur de service externe. Les nouveaux modèles arrivent par mise à jour à distance, comme chez Tesla.
Core a toutefois besoin d’une connexion Internet pour les recherches web, les e-mails et ces mises à jour logicielles. La promesse concerne donc le modèle d’IA et sa mémoire. Les recherches, les mails et les mises à jour continuent de passer par le réseau ; l’agent de la démonstration trouve lui aussi les déménageurs sur le web.
Javaid reconnaît un écart de qualité entre les modèles. Selon lui, les petits et moyens modèles ne sont pas encore au meilleur niveau, mais suffisent pour la plupart des tâches quotidiennes. Dans une ou deux générations de modèles, il ne s’attend plus à une différence notable entre le modèle Opus actuel et ce qui fonctionne sur Core. Buterin décrit une stratégie dans laquelle un modèle local sert de centre de pilotage et appelle de puissants modèles cloud comme outils pour les tâches plus exigeantes.
NVIDIA et Microsoft élargissent le marché
NVIDIA a conçu RTX Spark pour les PC Windows à l’ère des agents d’IA personnels. La plateforme associe un GPU Blackwell RTX à 6 144 cœurs CUDA et une CPU Grace à 20 cœurs, fournit jusqu’à 1 pétaflop de puissance de calcul pour l’IA et propose 128 Go de mémoire partagée. Des ordinateurs portables et de bureau devraient arriver à l’automne chez ASUS, Dell, HP, Lenovo, Microsoft Surface et MSI, puis chez Acer et Gigabyte. NVIDIA et Microsoft construisent ensemble une plateforme Windows sécurisée pour les agents exécutés sur l’appareil, avec de nouvelles fonctions de sécurité dans le système d’exploitation et NVIDIA OpenShell.
Le 7 octobre, Satya Nadella, CEO de Microsoft, Pavan Davuluri, responsable de Windows, et Jensen Huang, CEO de NVIDIA, prévoient d’apparaître ensemble à San Francisco. Ils doivent présenter des nouveautés concernant Windows, RTX Spark, Surface et l’écosystème PC. La livraison de Ghost Core est prévue pour le 31 octobre ; NVIDIA annonce les premiers ordinateurs portables et de bureau RTX Spark pour l’automne 2026.
Le point de vue de l’informatique d’entreprise
Selon Gartner, les organisations utiliseront d’ici 2027 les petits modèles d’IA spécialisés par tâche trois fois plus souvent que les grands modèles de langage généralistes. Sumit Agarwal, analyste chez Gartner, cite la baisse des coûts de calcul et d’exploitation ainsi qu’une meilleure précision sur les tâches spécialisées.
Tom Mainelli, Group Vice President pour Device & Consumer Research chez IDC, voit un obstacle sur les appareils d’entreprise. Les équipes IT auraient clairement indiqué qu’elles n’autoriseraient pas les logiciels autonomes sur les appareils gérés sans contrôle approprié. Mainelli estime que la question reste ouverte de savoir si les grands laboratoires d’IA concluront qu’une partie de leur inférence doit se faire sur le bureau du client.
Questions fréquentes
Y a-t-il des frais récurrents après l’achat de Ghost Core ?
Selon le fabricant, Core ne nécessite pas d’abonnement. L’appareil comprend 1 an de garantie et un droit de retour de 30 jours.
D’autres programmes peuvent-ils utiliser les modèles sur Core ?
Core fournit une interface compatible avec l’OpenAI Responses API. D’autres applications, scripts et agents peuvent ainsi accéder aux modèles locaux sans frais par token.
Pourquoi Core est-il moins cher qu’une NVIDIA DGX Spark ?
Javaid l’explique par les achats. Ghost aurait réservé des cartes graphiques aux prix d’avant la hausse et répercuterait l’économie sur les clients.
Sélection de la rédaction
cloudmagazinKolibri : un modèle d’IA allemand pour votre centre de donnéescloudmagazinLocation de GPU sans hyperscalers : que valent les Neo Clouds ?cloudmagazinGoogle Gemini en entreprise : ce que la loi sur l’IA imposePlus du réseau MBF Media
MyBusinessFutureIntelligence artificielle dans les produits médicaux : les nouvelles obligations de l’UESource de l’image : générée par IA (octobre 2026)
Traduit de l’original allemand par intelligence artificielle. La version allemande fait foi.


